Eine einzige Zeile reicht. Wer eine Benutzereingabe per Plus-Zeichen in einen SQL-Befehl klebt, hat eine Lücke gebaut, die seit über zwanzig Jahren bekannt ist und trotzdem in der aktuellen Top 10 der Webrisiken steht. Sichere Software entwickeln heißt deshalb vor allem: ein paar Gewohnheiten so früh lernen, dass du sie gar nicht mehr bewusst einschalten musst. Dieser Ratgeber zeigt dir aus Sicht der Verteidigung, welche Schwachstellen am häufigsten auftreten, warum sie entstehen und wie du sie vermeiden kannst.
Secure Coding, auf Deutsch sichere Programmierung oder sichere Codierung, gehört zum normalen Handwerk. Es ist so wichtig wie lesbare Namen oder Tests. Das gilt für kleine Websites genauso wie für eine Web Application mit vielen Benutzern, denn viele Angriffe laufen automatisiert gegen beliebige erreichbare Websites. Die Norm ISO/IEC 27001 führt „Secure coding“ in ihrem Anhang A sogar als eigene Maßnahme (8.28).
Typische Schwachstellen und ihre Folgen: die OWASP Top 10
Die OWASP-Stiftung (der Name stand bis 2023 für Open Web Application Security Project) veröffentlicht in Abständen eine Rangliste der größten Risiken für Webanwendungen. Die aktuelle Ausgabe heißt OWASP Top 10:2025. Ganz neu ist A10, der falsche Umgang mit Ausnahmezuständen. A03 erweitert die frühere Kategorie veralteter Komponenten auf die ganze Lieferkette, und Injection ist von Platz 3 auf Platz 5 gerutscht.
| Rang | Kategorie (2025) | Gegenmittel in einem Satz |
|---|---|---|
| A01 | Broken Access Control | Rechte bei jedem Zugriff serverseitig prüfen und standardmäßig verweigern. |
| A02 | Security Misconfiguration | Sichere Voreinstellungen ausliefern und Konfigurationen automatisiert überprüfen. |
| A03 | Software Supply Chain Failures | Abhängigkeiten aus vertrauenswürdigen Quellen beziehen, festschreiben und regelmäßig auf bekannte Lücken scannen. |
| A04 | Cryptographic Failures | Geprüfte Bibliotheken und aktuelle Verfahren verwenden, nie eigene Kryptographie bauen. |
| A05 | Injection | Parametrisierte Abfragen verwenden und Benutzereingaben nie als Code ausführen. |
| A06 | Insecure Design | Bedrohungen schon im Entwurf modellieren, bevor die erste Zeile Code entsteht. |
| A07 | Authentication Failures | Passwörter mit langsamen Hashverfahren speichern und Benutzern Mehr-Faktor-Anmeldung anbieten. |
| A08 | Software or Data Integrity Failures | Updates, Pakete und serialisierte Daten auf Integrität prüfen, etwa per Signatur. |
| A09 | Security Logging and Alerting Failures | Sicherheitsrelevante Ereignisse protokollieren und Alarme an Menschen weiterleiten. |
| A10 | Mishandling of Exceptional Conditions | Fehler abfangen, sicher scheitern und keine internen Informationen an Benutzer ausgeben. |
Für Angreifer sind diese Schwachstellen bequem, weil viele davon mit fertigen Tools automatisiert gesucht werden. Die Folgen reichen vom Abfluss sensibler Daten bis zum Stillstand ganzer Dienste. Häufig ist der unbefugte Zugriff auf ein einziges Konto der Anfang. Bei personenbezogenen Daten kommt die Meldepflicht nach Art. 33 DSGVO hinzu. Dafür bleiben 72 Stunden.
Der Zeitpunkt ist entscheidend. Eine fehlende Rechteprüfung im Entwurf zu beheben kostet einen Satz im Ticket. Steckt dieselbe Lücke schon in einer Anwendung mit echten Benutzern, kommen Analyse, Patch, Benachrichtigung und spätere Kontrollen dazu. Fehler früh zu beheben ist also einfach billiger.
Warum unsicherer Code entsteht
Kaum jemand baut eine Lücke mit Absicht. Meist steckt eine von wenigen Ursachen dahinter, und die meisten davon sind organisatorisch.
- Vertrauen in Benutzereingaben: Formularfelder, URL-Parameter, Dateien und Antworten externer Dienste wirken harmlos, solange man nur an den freundlichen Benutzer denkt.
- Zeitdruck: Sicherheit fällt beim Schätzen oft unter den Tisch, weil sie keine sichtbare Funktion ist.
- Kopierter Code: Ein Schnipsel aus einem alten Forenbeitrag oder einer KI-Antwort wandert ungeprüft ins Projekt.
- Unbekannte Abhängigkeiten: Ein Python- oder JavaScript-Projekt zieht schnell Dutzende Pakete nach, die niemand im Team je angesehen hat.
- Fehlendes Wissen: In vielen Ausbildungen kommt sichere Programmierung erst spät vor. Manche Entwickler lernen sie erst nach dem ersten Vorfall.
- Bekannt gewordene Lücken bleiben liegen: Das Update einer Bibliothek gibt es oft längst, es wird nur nicht eingespielt.
Der Haken: Unübersichtlicher Code ist auch schwer zu prüfen. Wer verschachtelte Funktionen mit zehn Aufgaben schreibt, übersieht auch die fehlende Rechteprüfung darin. Die Regeln aus unserem Beitrag zu Clean Code und lesbaren Funktionen helfen deshalb direkt bei der Erstellung von sicherem Code.
Gegenmittel: Grundsätze für sicheres Coding
Security by Design bedeutet, dass Sicherheit schon im Entwurf mitgedacht wird. Das BSI fordert im IT-Grundschutz-Baustein CON.8 „Software-Entwicklung“ als Basisanforderung, dass alle Eingabedaten vor der Weiterverarbeitung geprüft und bei Client-Server-Anwendungen auf dem Server validiert werden. Daraus ergeben sich fünf Best Practices für sicheres Coding.
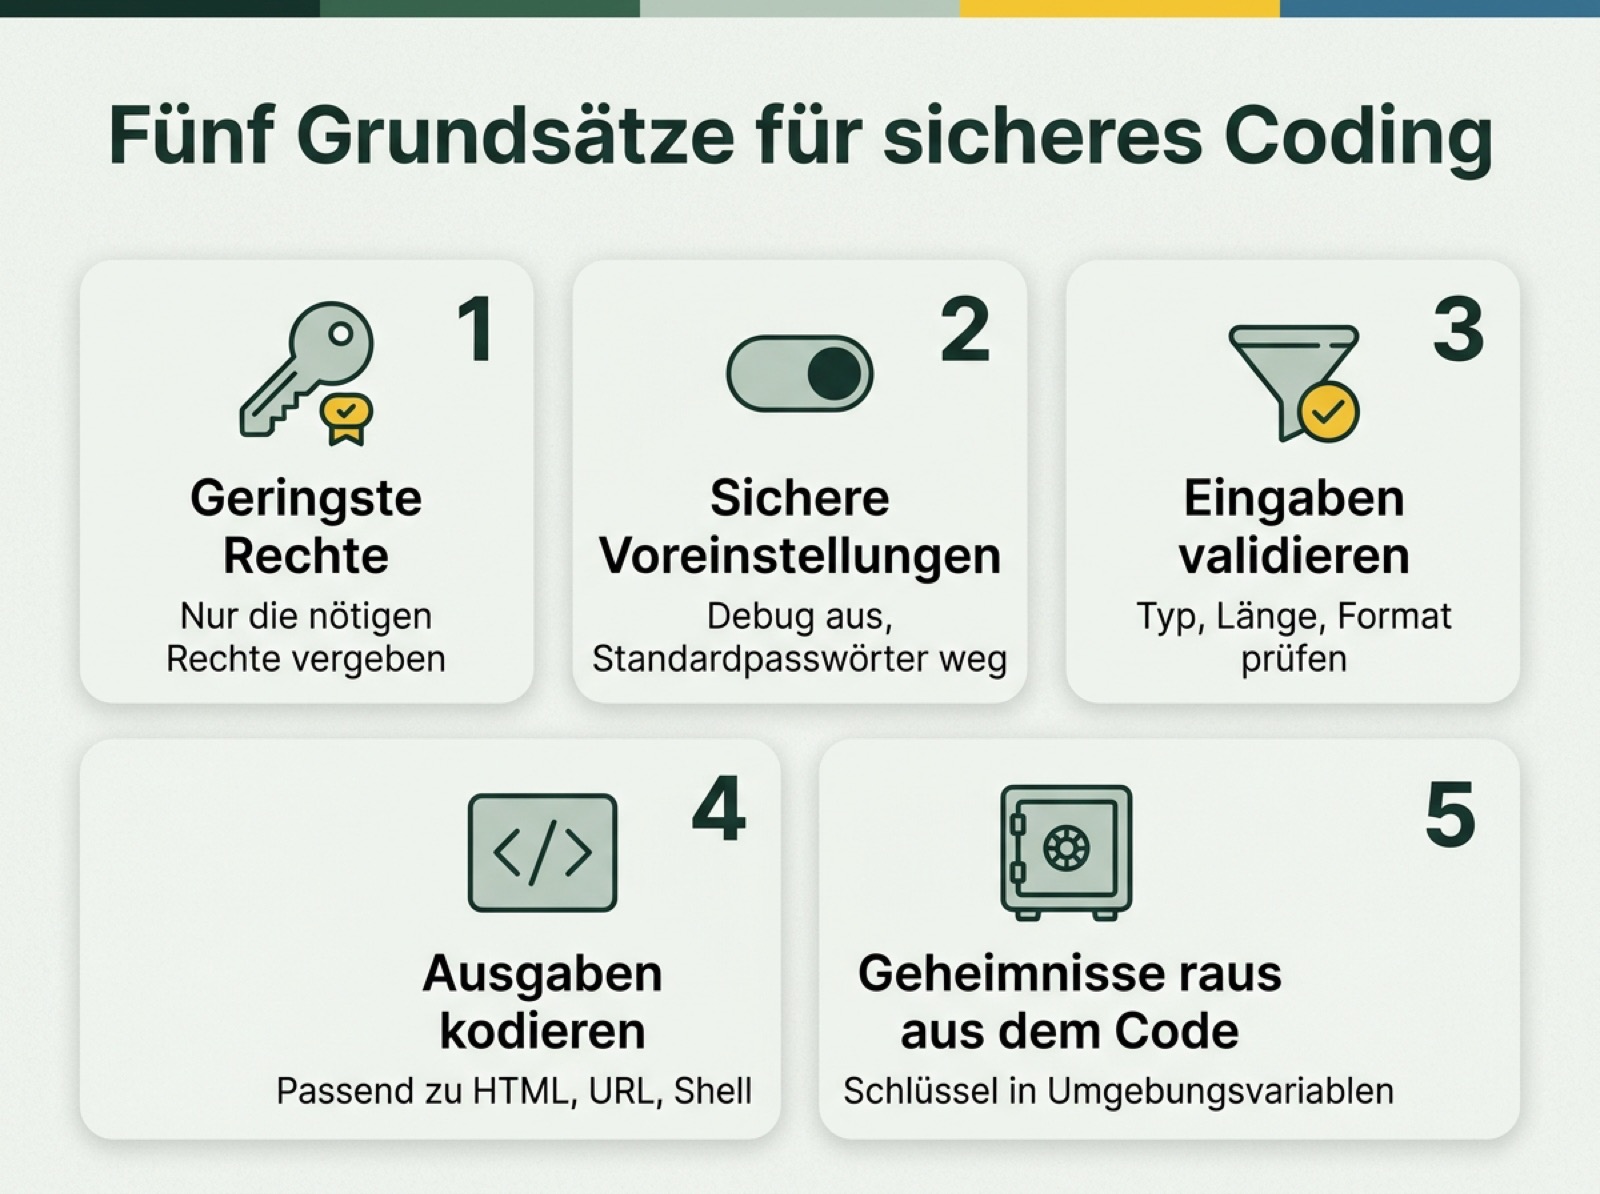
- Least Privilege (Prinzip der geringsten Privilegien): Ein Prozess bekommt nur die Rechte, die er für seine Aufgabe benötigt. Verwende für die Web-App ein eigenes Datenbankkonto, das lesen, aber keine Tabellen löschen darf. Übernimmt ein Angreifer die App, bleibt der Schaden begrenzt.
- Secure Defaults (sichere Voreinstellungen): Debug-Modus aus, Standardpasswörter weg. Wer etwas lockern will, muss es aktiv tun. Das schützt auch vor Fehlern beim Einrichten.
- Eingaben validieren: Validierung heißt, Typ, Länge, Format und Wertebereich zu überprüfen, am besten gegen eine Liste zulässiger Zeichen. Eine Postleitzahl hat in Deutschland fünf Ziffern. Alles andere lehnt der Server ab. Das verhindert viele Fehler, bevor sie tiefer im Code landen.
- Ausgaben kodieren: Daten, die in HTML, JavaScript oder eine Shell gelangen, brauchen eine Codierung passend zum Zielkontext. So verhinderst du Cross-Site-Scripting (XSS), bei dem fremdes Skript im Browser anderer Benutzer landet. Template-Engines wie Jinja2 übernehmen die HTML-Codierung, wenn Autoescaping eingeschaltet ist.
- Geheimnisse nicht im Code: API-Schlüssel und Datenbankpasswörter gehören in Umgebungsvariablen oder einen Secret-Manager. Diese Informationen sollten nie im Repository landen, denn was einmal in der Git-Historie liegt, bleibt dort sichtbar.
Ein sechster Punkt steht ebenfalls in CON.8.A5. Sensible Daten müssen verschlüsselt übertragen und gespeichert werden. Für die Verschlüsselung verwendest du die geprüften Bibliotheken deiner Sprache, nie eine eigene Konstruktion.
Beispiel 1: SQL-Injection verhindern mit parametrisierten Abfragen
Zuerst die Vorher-Variante. Der Text des Benutzers wird per Verkettung Teil des SQL-Befehls. Die Gefahr besteht darin, dass die Datenbank Daten und Befehl nicht mehr unterscheiden kann.
# Vorher (unsicher): Eingabe wird in den SQL-Text geklebt
sql = "SELECT id, name FROM kunden WHERE name = '" + name + "'"
Die sichere Fassung nutzt einen Platzhalter. Das Skript erstellt dafür eine kleine Tabelle im Arbeitsspeicher. Das Modul sqlite3 aus der Standardbibliothek übergibt den Wert getrennt vom Befehl, er bleibt reine Daten.
import sqlite3

con = sqlite3.connect(":memory:")
con.execute("CREATE TABLE kunden (id INTEGER PRIMARY KEY, name TEXT)")
con.executemany("INSERT INTO kunden (name) VALUES (?)", [("Ada",), ("Linus",)])

name = input("Name: ")

# Nachher (sicher): Platzhalter, die Eingabe bleibt reine Daten
zeilen = con.execute(
    "SELECT id, name FROM kunden WHERE name = ?", (name,)
).fetchall()
print(zeilen)
Gibst du Ada ein, liefert das Skript [(1, 'Ada')]. Parametrisierte Abfragen, auch Prepared Statements genannt, sind die wirksamste Möglichkeit, SQL-Injection zu verhindern. Du solltest sie auch in internen Tools nutzen, die nur Kollegen bedienen. In PostgreSQL mit psycopg heißt der Platzhalter %s, in ORMs wie SQLAlchemy erzeugt die Bibliothek die Abfragen selbst. Eine Validierung der Daten kommt zusätzlich dazu. Vor Injection schützen aber erst die Platzhalter.
Beispiel 2: Passwörter richtig speichern
Die Vorher-Variante ist ein schneller Hash ohne Salt. Gleiche Passwörter ergeben gleiche Werte. Ein Angreifer mit einer erbeuteten Datenbank kann MD5 auf einer Grafikkarte milliardenfach pro Sekunde berechnen.
# Vorher (unsicher): schneller Hash, kein Salt
hash_wert = hashlib.md5(passwort.encode()).hexdigest()
Für Passwörter brauchst du ein absichtlich langsames Verfahren mit zufälligem Salt. Der OWASP Password Storage Cheat Sheet empfiehlt an erster Stelle Argon2id, in Python etwa über das Paket argon2-cffi. Ohne Zusatzpaket geht scrypt aus hashlib, hier mit den dort genannten Mindestwerten N=2^17, r=8, p=1. Das sind rund 128 MiB Speicher pro Berechnung.
import hashlib, hmac, os

PARAMS = dict(n=2**17, r=8, p=1, maxmem=2**28, dklen=32)

def passwort_hashen(passwort: str) -> tuple[bytes, bytes]:
    salt = os.urandom(16)
    return salt, hashlib.scrypt(passwort.encode(), salt=salt, **PARAMS)

def passwort_pruefen(passwort: str, salt: bytes, referenz: bytes) -> bool:
    kandidat = hashlib.scrypt(passwort.encode(), salt=salt, **PARAMS)
    return hmac.compare_digest(kandidat, referenz)

salt, h = passwort_hashen("Sommer-Lernplan-42")
print(passwort_pruefen("Sommer-Lernplan-42", salt, h))
print(passwort_pruefen("sommer-lernplan-42", salt, h))
Die Ausgabe lautet True und dann False. Schon ein kleiner Anfangsbuchstabe fällt durch. Beide Funktionen benötigen nur die Standardbibliothek. Der fertige Hash besteht aus 32 Bytes. hmac.compare_digest vergleicht in konstanter Zeit und schützt so vor Timing-Angriffen: Angreifer können aus der Laufzeit nichts über den Referenzwert ablesen. Salt und Hash werden zusammen in der Datenbank gespeichert. Warum Hashfunktionen so arbeiten, erklärt unser Überblick zur Kryptographie und ihren Verfahren.
Sichere Software entwickeln im Team: Review, Tools, Grundschutz
Einzelne Gewohnheiten reichen nicht, wenn das Team keine gemeinsamen Regeln hat. Konkret heißt das: Sicherheit bekommt einen festen Platz im Ablauf, von der Planung bis zum Merge. Viele Teams halten ihre Regeln zur sicheren Codierung in Secure Coding Standards fest. Die Regeln helfen nur, wenn sich alle daran halten und jemand sie aktuell hält. Gute Vorlagen sind die OWASP Secure Coding Practices und die CERT Secure Coding Standards des Software Engineering Institute, etwa für C, C++ und Java.
Code Review mit Sicherheitsfragen
Erstellt jemand einen Pull Request, liest ihn eine zweite Person. So stellen Teams sicher, dass kein Code ungelesen in die Anwendung gelangt. Dabei helfen ein paar feste Fragen. Wird hier eine Eingabe verarbeitet? Wer darf diese Funktion aufrufen? Landet ein Geheimnis im Log?
SAST und Dependency-Scanning einordnen
Statische Analyse (SAST) durchsucht den Quellcode, ohne ihn auszuführen, nach bekannten Mustern für Schwachstellen. Häufig sind das verkettete SQL-Abfragen oder fest eingetragene Passwörter. Für Python gibt es dafür etwa Bandit. Solche Tools melden auch Fehlalarme. Sie nehmen dem Review Fleißarbeit ab, die Bewertung bleibt beim Menschen.
Beim Dependency-Scanning gleichen Werkzeuge wie pip-audit deine Abhängigkeiten mit Datenbanken bekannter Schwachstellen ab. Das passt zu A03 der Top 10 und zur BSI-Anforderung CON.8.A6: Externe Bibliotheken sollen aus vertrauenswürdigen Quellen stammen, ihre Integrität muss sichergestellt sein. Darüber hinaus erzeugen viele Teams eine Software Bill of Materials (SBOM), also eine Liste aller Komponenten einer Anwendung.
Tests von außen und BSI-Grundschutz
Vor wichtigen Releases lohnt ein Blick mit den Augen eines Angreifers, ausgeführt von Fachleuten mit Auftrag. Wie so ein Auftrag abläuft, steht in unserem Beitrag zu Penetration Testing und seinen Methoden.
Der BSI-Baustein CON.8 (Edition 2023) gibt für all das einen guten Rahmen. Er verlangt unter anderem eine Versionsverwaltung des Quellcodes (A10), eine Richtlinie für die Software-Entwicklung (A11), Schulungen für Entwickler (A14) und eine Bedrohungsmodellierung in der Entwurfsphase (A21). Für kleine Teams würden wir mit A5 und A6 anfangen: Benutzereingaben prüfen, sichere Voreinstellungen, saubere Bibliotheken. Beides sind Basisanforderungen, und du brauchst dafür keine neuen Werkzeuge.
Zum Weiterlesen: „Writing Secure Code“
„Writing Secure Code“ von Michael Howard und David LeBlanc gilt als Klassiker der sicheren Softwareentwicklung. Die zweite Auflage erschien Ende 2002 bei Microsoft Press (ISBN 978-0-7356-1722-3). Beide Autoren arbeiteten damals bei Microsoft an Sicherheitsthemen.
Das Buch behandelt Bedrohungsmodelle, Eingabeprüfung, sichere Voreinstellungen und wie man typische Fehler wie Pufferüberläufe vermeidet. Die Beispiele stammen überwiegend aus C, C++ und der Windows-Welt. Die Grundsätze lassen sich auf jede Sprache übertragen. Das Niveau ist mittel, du solltest schon programmieren können. Eine deutsche Übersetzung mit dem Titel „Sichere Software programmieren“ taucht antiquarisch auf. Den Steckbrief findest du auch in unserem Bücherregal für Entwickler.
Checkliste vor dem nächsten Merge
- Werden alle Daten von Benutzern serverseitig auf Typ, Länge und Format geprüft?
- Verwenden alle Datenbankabfragen ausschließlich Platzhalter?
- Landen Passwörter nur als Argon2id-, scrypt- oder bcrypt-Hash in der Datenbank?
- Liegt kein Schlüssel, Token oder Passwort im Repository?
- Läuft der Dienst mit den geringsten nötigen Rechten?
- Wurden neue Abhängigkeiten überprüft, gescannt und auf eine Version festgeschrieben?
- Hat eine zweite Person den Pull Request mit Blick auf Sicherheit gelesen?
Für den Anfang reicht es, aus dieser Liste eine Vorlage für Pull Requests zu erstellen. Nach ein paar Wochen laufen die Fragen beim Schreiben schon von selbst mit.