Du öffnest eine Datei, die du vor drei Monaten geschrieben hast, und verstehst sie nicht mehr. Variablen heißen t, x und tmp2, eine Funktion ist 150 Zeilen lang, und ein Kommentar behauptet etwas, das der Code längst nicht mehr tut. Clean Code setzt hier an. Gemeint ist eine Sammlung von Prinzipien und Praktiken, mit denen Code für Menschen lesbar bleibt, auch für dich selbst in einem halben Jahr. Hier findest du die wichtigsten Grundsätze mit Beispielen, typische Code Smells mit Gegenmitteln und eine ehrliche Einordnung der Kritik.
Was unlesbarer Code kostet
Du liest Code viel öfter, als du ihn schreibst. Wie groß der Unterschied ist, zeigt eine Feldstudie mit 78 professionellen Entwicklern aus sieben Projekten: Im Schnitt ging rund 58 Prozent ihrer Arbeitszeit dafür drauf, vorhandenen Code zu verstehen. Wer beim Tippen ein paar Minuten spart, zahlt das später beim Lesen mit Stunden zurück, und meistens zahlt das ganze Team mit.
Die Folgen zeigen sich im Projektalltag. Neue Features dauern länger, weil vor jeder Anpassung erst der bestehende Code verstanden werden muss. Fehler verstecken sich in Methoden, die zu viel auf einmal tun. Und neue Leute im Team brauchen Wochen, bis sie sich trauen, etwas anzufassen. Das Fachwort für diese Probleme ist technische Schulden: Jede unsaubere Stelle ist ein kleiner Kredit, auf den du bei jeder Änderung Zinsen zahlst.
Lesbarkeit hängt deshalb direkt mit der Softwarequalität zusammen. Wartbarer Code entscheidet in der Softwareentwicklung darüber, ob ein Projekt auch im dritten Jahr noch zügig neue Anforderungen aufnehmen kann.
Wie Code schleichend unlesbar wird
Schlechten Code schreibt kaum jemand mit Absicht. Er wächst langsam, und die Gründe dafür sind meist verständlich:
- Zeitdruck: Der schnelle Fix vor dem Release bleibt im Code, das Aufräumen kommt nie.
- Wachsende Anforderungen: Eine Methode, die einmal eine Sache tat, bekommt Sonderfall um Sonderfall dazu.
- Fehlende Absicherung: Ohne automatisierte Tests traut sich niemand, alten Code umzubauen. Also wird drumherum programmiert.
- Keine gemeinsamen Absprachen: Jeder im Projekt schreibt in seinem Stil, und die Codebasis liest sich wie fünf verschiedene Bücher.
Der Haken: Jede einzelne dieser Entscheidungen wirkt harmlos. Erst in der Summe entsteht Code, den niemand mehr gern öffnet. Das trifft häufig auch erfahrene Teams, denn die Ursachen liegen eher in der Organisation als im Können.
Clean-Code-Prinzipien, die im Alltag am meisten bringen
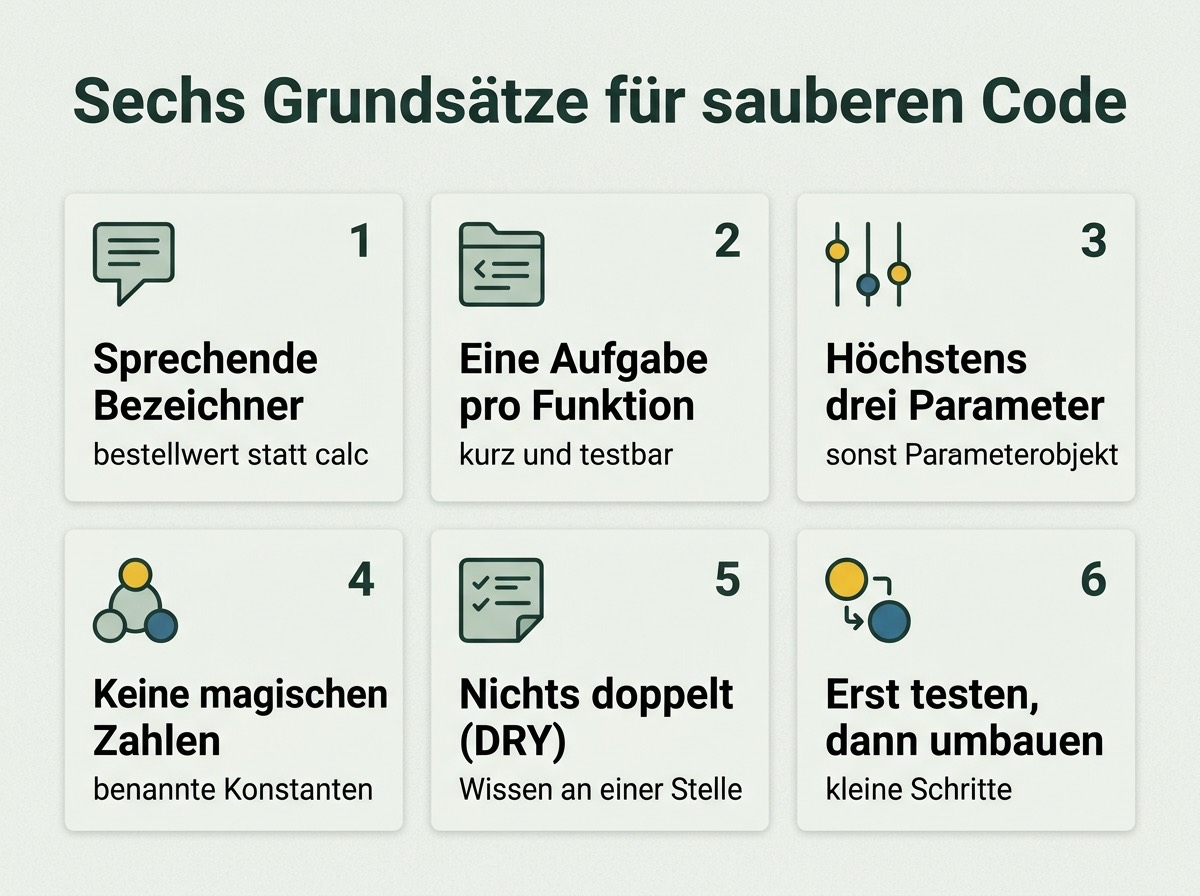
Die Ideen gehen zu einem guten Teil auf Robert C. Martin zurück, dessen Buch „Clean Code“ von 2008 den Begriff bekannt gemacht hat. Du musst nicht alles auf einmal umsetzen. Für den Anfang reichen drei Gewohnheiten, die fast sofort Wirkung zeigen.
Namen, die erklären, was passiert
Ein guter Bezeichner beantwortet die Frage, wozu eine Variable da ist. Ein Beispiel in Python, vorher:
def calc(l):
    t = 0
    for x in l:
        if x[1] > 0:
            t += x[1] * x[2]
    return t
Nachher, mit demselben Verhalten:
def bestellwert(positionen):
    summe = 0
    for _artikel, menge, einzelpreis in positionen:
        if menge > 0:
            summe += menge * einzelpreis
    return summe
Die zweite Fassung kommt ohne Kommentar aus. Beim Lesen ist sofort klar: Hier wird Menge mal Einzelpreis aufsummiert. Gute Bezeichner kannst du aussprechen und per Suche leicht finden. Abkürzungen, die nur du kennst, gehören nicht hinein.
Kleine Funktionen mit einer Aufgabe
Martin empfiehlt, dass jede Funktion genau eine Sache tut und kaum länger als 20 Zeilen ist. Bei den Parametern rät er zu höchstens drei, alles darüber braucht eine gute Begründung. Im Vorher-Beispiel prüft, rechnet und druckt ein einziger Block alles in einem Rutsch:
def verarbeite(bestellung):
    if not bestellung["positionen"]:
        raise ValueError("Bestellung ist leer")
    summe = sum(p["menge"] * p["preis"] for p in bestellung["positionen"])
    if bestellung["kunde"]["stammkunde"]:
        summe = summe * 0.95
    print(f"Rechnung für {bestellung['kunde']['name']}: {summe:.2f} Euro")
Nachher hat jede Aufgabe ihre eigene Funktion, und die magische Zahl 0.95 ist eine benannte Konstante:
RABATT_STAMMKUNDE = 0.05

def pruefe_nicht_leer(bestellung):
    if not bestellung["positionen"]:
        raise ValueError("Bestellung ist leer")

def gesamtbetrag(bestellung):
    summe = sum(p["menge"] * p["preis"] for p in bestellung["positionen"])
    if bestellung["kunde"]["stammkunde"]:
        summe -= summe * RABATT_STAMMKUNDE
    return summe

def drucke_rechnung(bestellung):
    pruefe_nicht_leer(bestellung)
    betrag = gesamtbetrag(bestellung)
    print(f"Rechnung für {bestellung['kunde']['name']}: {betrag:.2f} Euro")
Jetzt kannst du gesamtbetrag einzeln testen, ohne dass etwas auf dem Bildschirm landet. Die Implementierung ist etwas länger, dafür sollten neue Rabattarten nur noch eine Stelle berühren. Wenn du gerade erst mit der Sprache anfängst, hilft dir unser Leitfaden Python lernen, solche Beispiele selbst nachzubauen.
Kommentare erklären das Warum
Kommentare, die nur nacherzählen, was ohnehin dasteht, veralten beim nächsten Umbau. Sinnvoll sind Kommentare dort, wo der Code etwas nicht ausdrücken kann: eine fachliche Begründung, ein Verweis auf ein Ticket, eine bewusste Abweichung von der Regel. Faustregel: Brauchst du einen Kommentar, um zu erklären, was eine Zeile tut, ist meistens der Bezeichner schlecht gewählt.
Code Smells erkennen und mit Refactoring beheben
Ein Code Smell ist ein Hinweis darauf, dass etwas mit der Struktur nicht stimmt. Der Begriff stammt von Kent Beck und wurde durch Martin Fowlers Standardwerk zum Umbau von Code bekannt. Gemeint ist beim Refactoring, die innere Struktur zu verbessern, ohne das Verhalten zu ändern. Die folgende Tabelle zeigt typische Smells und das passende Gegenmittel:
| Code Smell | Woran du ihn erkennst | Gegenmittel |
|---|---|---|
| Duplizierter Code | Dieselbe Logik steht an mehreren Stellen | An einer Stelle zusammenführen |
| Lange Funktion | Du musst scrollen, um sie zu überblicken | Teilaufgaben herauslösen (Extract Function) |
| Lange Parameterliste | Vier oder mehr Argumente | Parameterobjekt oder Datenklasse einführen |
| Große Klasse | Viele Felder, viele unverbundene Methoden | Nach Verantwortung aufteilen |
| Magische Zahlen | Werte wie 0.95 oder 86400 ohne Bezeichnung | Benannte Konstante |
| Feature Envy | Eine Methode greift ständig auf fremde Daten zu | Methode dorthin verschieben, wo die Daten liegen |
| Erklärender Kommentar | Kommentar beschreibt unklaren Code | Code umbenennen oder extrahieren, Kommentar löschen |
Wichtig dabei: Umbauen ohne Absicherung ist ein Glücksspiel. Schreib zuerst Unit-Tests für das bestehende Verhalten, dann baue in Schritten von wenigen Minuten um und lass die Testsuite nach jedem Schritt laufen.
DRY, KISS, YAGNI und SOLID kurz erklärt
Neben den konkreten Praktiken gibt es eine Handvoll Prinzipien, die in fast jedem Gespräch über sauberen Code fallen. Sie helfen, typische Entwurfsfehler bereits früh zu vermeiden:
- DRY (Don’t Repeat Yourself): Jedes Stück Wissen soll im System genau eine Stelle haben. Ändert sich der Mehrwertsteuersatz, passt du genau eine Konstante an.
- KISS (Keep It Simple, Stupid): Die einfachste Lösung, die funktioniert, ist meistens die beste. Cleverer Code mit drei verschachtelten Ausdrücken in einer Zeile spart selten etwas.
- YAGNI (You Aren’t Gonna Need It): Baue keine Features auf Vorrat, die vielleicht irgendwann gebraucht werden. Das Prinzip stammt aus dem Extreme Programming.
- SOLID: Fünf Entwurfsprinzipien für objektorientierten Code, vom Clean-Code-Autor zusammengestellt. Single Responsibility, Open/Closed, Liskov Substitution, Interface Segregation und Dependency Inversion.
SOLID wirkt vor allem auf der Ebene von Klassen, Modulen und ihren Abhängigkeiten. Bevor du einen Baustein nach Verantwortlichkeiten aufteilst, hilft es, den Ist-Zustand als Klassendiagramm zu skizzieren. Wie das geht, zeigt unser Beitrag zu UML-Diagrammen.
Clean Code im Team umsetzen
Absprachen, die nur eine Person befolgt, halten im Projekt nicht lange. Das Team braucht eine gemeinsame Basis. Konkret heißt das:
- Stil festlegen und automatisieren: In Python ist PEP 8 der übliche Styleguide. Wenn ihr einen Formatierer wie Black und einen Linter wie Ruff nutzt, setzen die Werkzeuge ihn bei jedem Commit durch, ohne dass jemand darüber diskutieren muss.
- Code Reviews ernst nehmen: Jeder Pull Request wird von mindestens einer zweiten Person gelesen. Die Leitfrage lautet: Verstehe ich das ohne Erklärung?
- Pfadfinderregel: Hinterlasse jede Datei etwas sauberer, als du sie vorgefunden hast. Ein besserer Name hier, eine extrahierte Funktion dort.
- Zeit fürs Aufräumen einplanen: Rechne den Aufwand dafür in jede Aufgabe mit ein, sonst fällt er immer hinten runter.
Für Einsteiger lohnt sich außerdem Pair Programming. Zu zweit am selben Code merkst du schnell, welche Bezeichnungen nur in deinem Kopf Sinn ergeben.
Wer einen strukturierten Einstieg sucht, findet ihn bei der deutschen Initiative Clean Code Developer. Sie ordnet Prinzipien und Praktiken in aufeinander aufbauende Grade mit Farben von Rot bis Blau. Du arbeitest sie nacheinander durch und übst jeden Grad kontinuierlich im Alltag.
Wo Clean Code an Grenzen stößt
Umstritten sind die Grundsätze trotzdem. Die bekannteste Debatte führten Martin und John Ousterhout, Informatikprofessor in Stanford und Autor von „A Philosophy of Software Design“, zwischen September 2024 und Februar 2025; nachlesen kannst du sie in einem öffentlichen GitHub-Repository. Ousterhout hält viele sehr kleine Methoden für schädlich: Sie seien „flach“, und wer sie liest, müsse ständig zwischen ihnen springen, um das Ganze zu verstehen. Auch Martins Skepsis gegenüber Kommentaren sieht er kritisch.
Ein zweiter Einwand kommt aus der Performance-Ecke. Der Entwickler Casey Muratori zeigte 2023 an einem Beispiel mit geometrischen Formen, dass eine stark auf Polymorphie und Vererbung setzende Struktur in rechenintensiven Schleifen deutlich langsamer laufen kann als ein schlichter, direkter Ansatz.
Unsere Einschätzung: Behandle Clean Code als Werkzeugkasten, aus dem du nimmst, was zum Projekt passt. Sprechende Bezeichner und das Auslagern klar getrennter Aufgaben helfen fast immer. Bei der Länge von Methoden und bei Kommentaren lohnt es, im Team abzuwägen, statt Zeilenzahlen zu zählen.
Zwei Bücher zum Weiterlesen
- „Clean Code“ von Robert C. Martin: Das Grundlagenwerk zu Benennung, Kommentaren, Fehlerbehandlung und Testen, im Original mit dem Untertitel „A Handbook of Agile Software Craftsmanship“. Die erste Auflage von 2008 arbeitet mit Java-Beispielen, die zweite englische Auflage von 2025 zeigt Beispiele in mehreren Sprachen, darunter Python. Eine deutsche Übersetzung gibt es beim mitp Verlag. Niveau: Mittel, gut ab dem ersten größeren eigenen Projekt.
- „Refactoring“ von Martin Fowler: Ein Katalog kleiner, sicherer Umbauschritte, jeweils mit Anlass und Ablauf, dazu das Kapitel über Code Smells. Die zweite Auflage von 2018 nutzt JavaScript-Beispiele. Niveau: Mittel, besonders nützlich, wenn du mit gewachsenem Code arbeitest.
Beide Titel findest du mit Kurzporträt auch in unserem Bücherregal. Welche Klassiker daneben noch lohnen, von „The Pragmatic Programmer“ bis „Code Complete“, ordnet die Übersicht der Bücher für Softwareentwickler ein.
Checkliste für deinen nächsten Pull Request
- Verrät jeder Bezeichner, wofür die Variable da ist?
- Tut jede Funktion genau eine Sache, und hat sie höchstens drei Parameter?
- Stehen Zahlen mit Bedeutung als benannte Konstante im Code?
- Gibt es duplizierte Logik, die du zusammenführen kannst?
- Erklären die Kommentare, warum etwas so gelöst ist?
- Laufen alle Tests nach dem Umbau grün?
Druck dir die sechs Fragen aus oder leg sie als Vorlage für Pull Requests im Repository ab. Dann prüfst du sie bei jeder Änderung, ohne daran denken zu müssen.