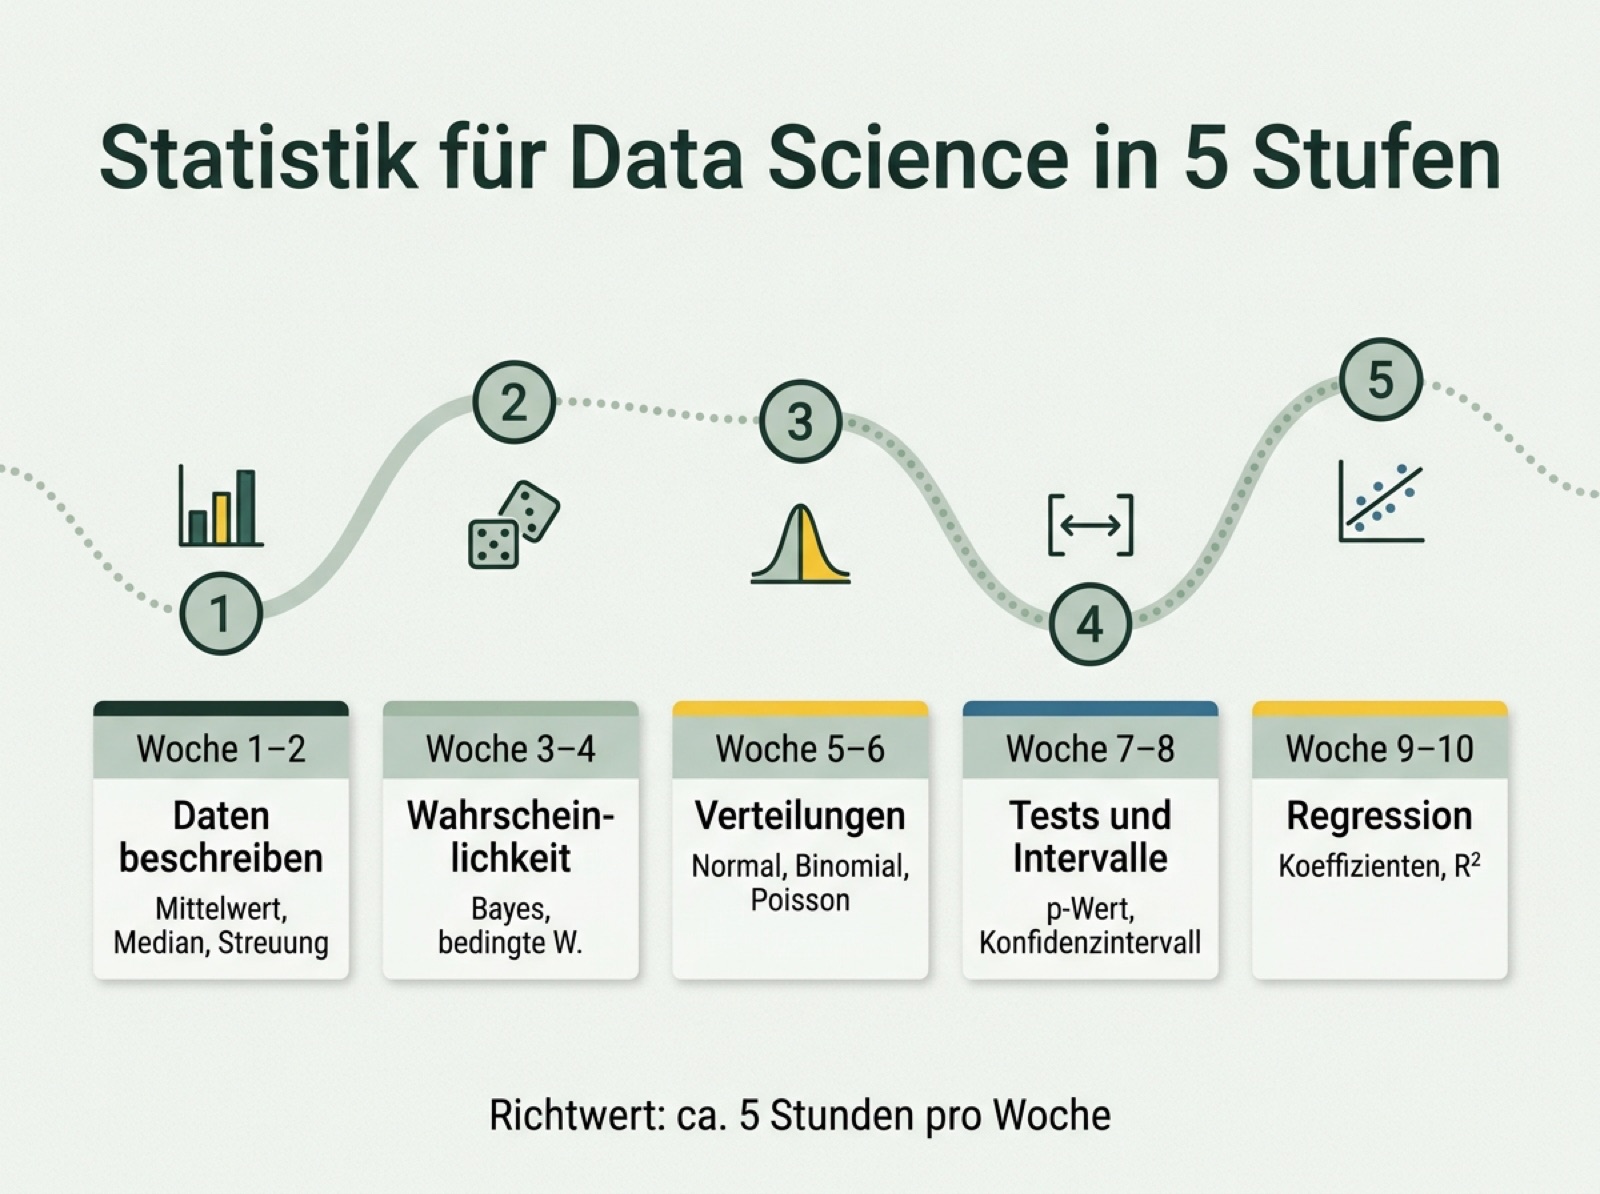
Für Data Science brauchst du weniger Formeln, als viele Lehrbücher vermuten lassen, aber die richtigen in der richtigen Reihenfolge. Wer Statistik lernen will, um Daten auszuwerten oder später die Modelle des maschinellen Lernens zu verstehen, kommt mit fünf Bausteinen sehr weit: beschreibende Statistik, Wahrscheinlichkeit, Verteilungen, Hypothesentests mit Konfidenzintervallen und Regression. Für diese statistischen Grundlagen reicht Mathematik auf Oberstufenniveau, ein Studium brauchst du dafür nicht. Dieser Lernpfad beantwortet die Fragen, die Einsteiger am häufigsten stellen, und endet mit einem Plan für etwa zehn Wochen.
Welche Statistik braucht man für Data Science?
Data Science ist im Kern Datenanalyse mit Code. Du beschreibst Daten und schätzt, wie sicher eine Aussage ist. Später baust du Modelle, die einen Zusammenhang zwischen Variablen abbilden. Dafür brauchst du fünf Themen, die in fast jeder Einführung in die Statistik vorkommen:
- Deskriptive Statistik: Mittelwert, Median, Modus, Varianz, Standardabweichung, Quantile. Damit fasst du einen Datensatz in wenigen Zahlen zusammen.
- Wahrscheinlichkeit: Rechenregeln, bedingte Wahrscheinlichkeit, der Satz von Bayes. Hier lernst du, Unsicherheit in Zahlen auszudrücken.
- Verteilungen: Normal-, Binomial- und Poisson-Verteilung genügen für den Anfang.
- Inferentielle Statistik: Stichprobe, Konfidenzintervall, Hypothesentests, p-Wert, Fehler 1. und 2. Art.
- Regression: lineare Regression mit Koeffizienten und R², danach multiple und logistische Regression.
Was du für den Einstieg weglassen kannst: Beweise, Maßtheorie und die Herleitung jeder Verteilung. Die Konzepte musst du verstehen und anwenden können, die Formeln schlägt man nach. Weitere statistische Methoden wie Zeitreihen oder Clustering kommen dazu, wenn ein Projekt sie verlangt. Für die Auswahl statistischer Analysen in einem Einsteigerprojekt reichen die fünf Bausteine. Den Rest lernst du nach Bedarf.
In welcher Reihenfolge solltest du lernen?
Die Reihenfolge folgt einer einfachen Logik: Jede Stufe nutzt die vorige. Ohne Varianz verstehst du keine Verteilung, ohne Verteilung kein Konfidenzintervall. Prüfe nach jeder Stufe mit der kleinen Checkliste, ob du weitergehen kannst.
Stufe 1: Grundlagen der deskriptiven Statistik
Starte mit einem echten Datensatz, etwa aus dem Open-Data-Portal deiner Stadt oder aus einem Kurs. Berechne Kennzahlen und zeichne Histogramme und Boxplots.
- Du kannst erklären, warum der Median bei Gehältern aussagekräftiger ist als der Mittelwert.
- Du erkennst Ausreißer im Boxplot.
- Du weißt, was eine Standardabweichung von 12 Punkten bei einem Durchschnitt von 59 bedeutet.
Stufe 2: Wahrscheinlichkeit
Danach kommt die Wahrscheinlichkeitsrechnung. Ein Beispiel für bedingte Wahrscheinlichkeit: Ein Test erkennt eine seltene Eigenschaft in 99 von 100 Fällen. Wie wahrscheinlich ist sie trotzdem, wenn der Test anschlägt? Die Berechnung mit dem Satz von Bayes zeigt, warum die Antwort oft überrascht.
- Du kannst P(A|B) und P(B|A) auseinanderhalten.
- Du rechnest eine Aufgabe mit dem Satz von Bayes von Hand.
Stufe 3: Verteilungen
Jetzt lernst du, wie Daten typischerweise streuen. In der Praxis wird die Normalverteilung am häufigsten verwendet: Rund 95 % der Werte liegen innerhalb von etwa zwei Standardabweichungen um die Mitte. Simuliere Verteilungen in Python, das macht sie greifbarer als jede Tabelle.
Stufe 4: Tests und Konfidenzintervalle
Ab hier hilft dir Statistik bei Entscheidungen. Ein Konfidenzintervall sagt, in welchem Bereich der wahre Wert vermutlich liegt. Statistische Hypothesentests prüfen, ob ein Unterschied zufällig sein kann. Der Haken: p-Werte werden oft falsch gedeutet. Ein p-Wert unter 0,05 heißt nicht, dass ein Effekt groß oder wichtig ist.
- Du formulierst Null- und Alternativhypothese für einen A/B-Test.
- Du kennst den Unterschied zwischen t-Test und Chi-Quadrat-Test.
- Du kannst erklären, welche Entscheidungen ein Konfidenzintervall stützt und welche nicht.
Stufe 5: Regression
Die lineare Regression führt direkt zu den Methoden des maschinellen Lernens. Du lernst, Koeffizienten zu lesen, R² einzuordnen und Residuen zu prüfen. Wer hier sicher ist, versteht später auch die Modelle aus unserem Lernpfad Machine Learning lernen deutlich schneller.
Python oder R für Statistik?
Beide Sprachen sind kostenlos, und für beide gibt es seit Jahren gut gepflegte Pakete. R wurde für Statistik gebaut, viele Verfahren aus Lehrbüchern gibt es dort direkt, und mit ggplot2 und dem tidyverse arbeitest du sehr kompakt. Python ist breiter einsetzbar: Mit pandas, NumPy, SciPy, statsmodels und Seaborn deckst du Statistik ab, und mit scikit-learn steigst du in derselben Umgebung ins Machine Learning ein.
| Kriterium | Python | R |
|---|---|---|
| Stärke | Datenanalyse plus Software und KI | Statistische Verfahren und Grafiken |
| Wichtige Pakete | pandas, NumPy, SciPy, statsmodels | tidyverse, ggplot2 |
| Typischer Bereich | Unternehmen, Projekte mit Deep Learning | Forschung, Biostatistik, Sozialwissenschaften |
| Einstieg | etwas mehr Programmierung vorab | Statistik schneller im Vordergrund |
Für Data Science würden wir Python nehmen, weil du dieselbe Sprache später für Modelle und Automatisierung nutzen kannst. Falls du noch keine Zeile Code geschrieben hast, lies zuerst unseren Plan Python lernen. Beides parallel zu lernen funktioniert, wenn du in den ersten zwei bis drei Wochen nur programmierst.
Wie sieht das in Python aus?
Für ein erstes Gefühl brauchst du nicht einmal pandas. Das Modul statistics gehört zur Standardbibliothek, und seit Python 3.10 bringt es auch Korrelation und lineare Regression mit, wie die offizielle Python-Dokumentation zum Modul statistics beschreibt. Im Beispiel wird nur diese Standardbibliothek verwendet. Die Zahlen sind ausgedacht: wöchentliche Lernstunden und erreichte Punkte in einem Übungstest.
from statistics import mean, median, stdev, correlation, linear_regression, NormalDist

# Ausgedachte Übungsdaten: Lernstunden je Woche und erreichte Punkte
stunden = [2, 3, 3, 4, 5, 5, 6, 7, 8, 9]
punkte = [41, 48, 45, 52, 60, 57, 63, 70, 72, 79]

print("Durchschnitt:", mean(punkte))
print("Median:", median(punkte))
print("Standardabweichung:", round(stdev(punkte), 2))

# 95-%-Konfidenzintervall für den Durchschnitt (Normalnäherung)
z = NormalDist().inv_cdf(0.975)
fehler = z * stdev(punkte) / len(punkte) ** 0.5
print("95-%-KI:", round(mean(punkte) - fehler, 1), "bis", round(mean(punkte) + fehler, 1))

print("Korrelation:", round(correlation(stunden, punkte), 3))
steigung, achse = linear_regression(stunden, punkte)
print(f"Regression: punkte = {achse:.1f} + {steigung:.2f} * stunden")
Die Ausgabe des Skripts, ausgeführt unter Version 3.13:
Durchschnitt: 58.7
Median: 58.5
Standardabweichung: 12.47
95-%-KI: 51.0 bis 66.4
Korrelation: 0.994
Regression: punkte = 30.7 + 5.39 * stunden
Konkret heißt das: Jede zusätzliche Lernstunde bringt in diesen Daten im Schnitt 5,39 Punkte. Für große Datenmengen nimmst du später pandas und statsmodels, die Ergebnisse bleiben dieselben. Eine Korrelation von 0,994 ist bei echten Daten fast nie zu sehen, und sie beweist keine Ursache. Auch das Intervall hat eine Schwäche, die du in Stufe 4 lernst: Bei nur zehn Werten wäre die t-Verteilung genauer, das Intervall würde etwas breiter. Findest du solche Einwände selbst, hast du Stufe 4 verstanden.
Wie lange dauert es, Statistik zu lernen?
Bei etwa 5 Stunden pro Woche kannst du mit rund zehn Wochen für die Grundlagen rechnen, das sind gut 20 Stunden pro Monat. Das ist ein Richtwert. Mit Erfahrungen aus dem Studium geht es schneller, und wer erst Python lernt, sollte etwa drei Wochen dazurechnen.
| Wochen | Stufe | Praktische Übung |
|---|---|---|
| 1–2 | Daten beschreiben | Kennzahlen und Histogramme zu einem offenen Datensatz erstellen |
| 3–4 | Wahrscheinlichkeit | Würfel- und Münzexperimente simulieren, Bayes-Aufgaben rechnen |
| 5–6 | Verteilungen | Normal- und Binomialverteilung simulieren und vergleichen |
| 7–8 | Tests und Konfidenzintervalle | einen A/B-Test mit Beispieldaten auswerten |
| 9–10 | Regression | Regression mit statsmodels, Residuen prüfen |
Plane nach Woche 10 ein kleines eigenes Projekt ein. Neue Fähigkeiten sitzen erst nach der ersten echten Anwendung. Du lernst lieber in einem Kurs? Dann achte darauf, dass er alle fünf Stufen abdeckt und Übungen mit Code enthält. Ein Beispiel: Wetterdaten deiner Region auswerten und prüfen, ob der Oktober wärmer geworden ist. Willst du Ergebnisse lieber in Dashboards zeigen, findest du in Power BI lernen das passende Werkzeug für Berichte.
Welche Bücher eignen sich zur Einführung?
Zwei Titel passen gut zu diesem Lernpfad, wenn du möglichst praxisnah lernen willst. Beide stehen auch in unserem Bücherregal:
- Practical Statistics for Data Scientists von Peter Bruce, Andrew Bruce und Peter Gedeck: erklärt über 50 statistische Konzepte aus Sicht der Data Science, mit Beispielen in R und Python. Die deutsche Ausgabe heißt „Praktische Statistik für Data Scientists“ und ist 2021 in der 2. Auflage bei O’Reilly erschienen. Sie setzt Kenntnisse in einer der beiden Sprachen voraus.
- Python for Data Analysis von Wes McKinney: das Handbuch zu pandas und NumPy, geschrieben vom Entwickler von pandas. Statistik erklärt es nur am Rand, dafür lernst du das Werkzeug gründlich. Die deutsche Fassung „Datenanalyse mit Python“ erschien 2023 in der 3. Auflage, aktualisiert auf Python 3.10 und pandas 1.4.
Für den Einstieg würden wir mit dem Statistikbuch anfangen und McKinney als Nachschlagewerk danebenlegen, sobald du mit größeren Tabellen arbeitest.
Dein erster Schritt diese Woche
Nimm dir einen Datensatz, der dich wirklich interessiert, und beantworte drei Fragen: Was ist der typische Wert, wie stark streuen die Daten, und gibt es Ausreißer? Mehr braucht Stufe 1 nicht. Schreib dir die Antworten auf, daraus entstehen oft die ersten Fragen für einen Test in Stufe 4. Für die ersten Wochen reichen Python, ein Notebook und eine Stunde an fünf Abenden.