Wie viel Mathe brauche ich wirklich? Diese Frage stellen fast alle, die Machine Learning lernen wollen, und sie hält viele vom Anfangen ab. Die ehrliche Antwort: weniger als ein Mathestudium, mehr als null. Für die klassischen Verfahren reichen Schulmathe der Oberstufe, ein paar Begriffe aus der Statistik und die Bereitschaft, Formeln in Python nachzurechnen. Wie das konkret aussieht, zeigt dir dieser Lernweg. Er dauert als Richtwert 16 Wochen bei etwa 5 Stunden pro Woche.
Eine Voraussetzung gibt es: Du solltest Python-Grundlagen beherrschen. Schleifen, Funktionen, Listen und Dictionaries sollten sitzen. Falls nicht, beginne mit unserem Lernweg für Python in 12 Wochen und komm danach hierher zurück.
Wie viel Mathe braucht maschinelles Lernen?
Maschinelles Lernen ist ein Bereich der künstlichen Intelligenz, in dem Systeme aus Beispielen lernen. Algorithmen erkennen Muster in großen Datenmengen und können so Entscheidungen treffen, ohne dass jemand jede Regel explizit programmiert. Fachleute unterscheiden drei Lernformen: überwachtes Lernen mit beschrifteten Beispielen, unüberwachtes Lernen ohne Beschriftung und Reinforcement Learning, bei dem ein Programm über Belohnungen lernt. Dieser Lernweg bleibt bei den ersten beiden.
Dahinter steckt Mathematik, das stimmt. Herleiten musst du sie für den Anfang nicht. Du solltest verstehen, was eine Formel mit deinen Daten macht.
Konkret brauchst du für die ersten Monate:
- Statistik: Mittelwert, Median, Varianz, Standardabweichung, Korrelation und die Normalverteilung. Damit beschreibst du eine Tabelle voller Zahlen und erkennst Ausreißer.
- Lineare Algebra: Vektoren, Matrizen und die Matrixmultiplikation. Ein Datensatz in Python ist nichts anderes als eine Matrix mit einer Zeile pro Beispiel.
- Wahrscheinlichkeit: bedingte Wahrscheinlichkeit und was eine Wahrscheinlichkeit von 0,8 in einer Prognose bedeutet.
- Etwas Analysis, genauer die Idee der Ableitung. Sie erklärt, wie ein Algorithmus beim Training seine Fehler Schritt für Schritt kleiner macht (Gradientenabstieg).
Was du für den Einstieg nicht brauchst: Beweise, Integralrechnung über mehrere Variablen oder Maßtheorie. Wichtig werden sie erst für fortgeschrittene Ziele, etwa wenn du Forschungsartikel lesen oder eigene Verfahren entwickeln willst. Unsere Einschätzung: Wer in der Oberstufe Mathe durchgehalten hat, kommt mit gezieltem Nachlernen gut durch die 16 Wochen.
Machine Learning lernen: der Plan für 16 Wochen
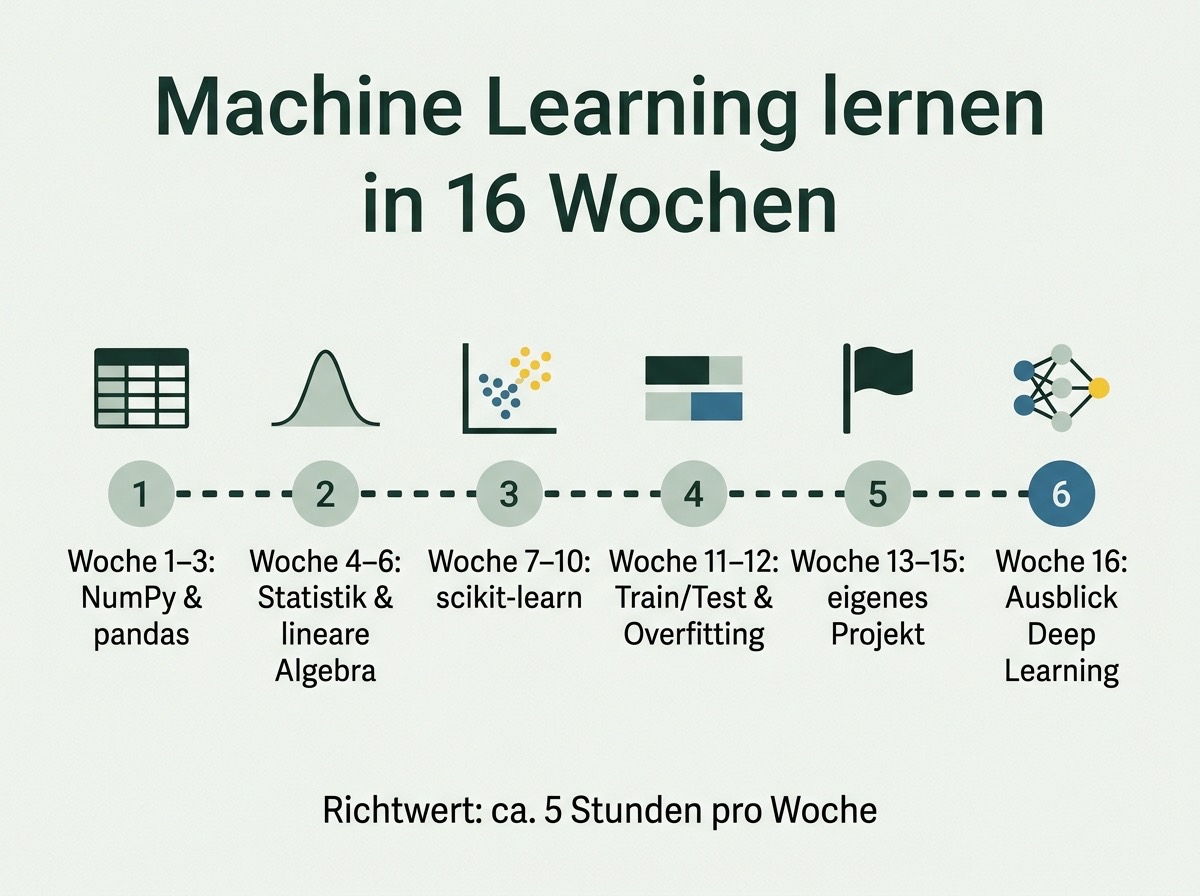
Die Tabelle zeigt, wie du die 16 Wochen aufteilen kannst. Die Wochen sind ein Richtwert bei rund 5 Stunden pro Woche, also etwa 80 Stunden insgesamt. Brauchst du für einen Block länger, ist das normal.
| Wochen | Schwerpunkt | Ergebnis am Ende |
|---|---|---|
| 1–3 | NumPy, pandas, Matplotlib | Du lädst eine CSV-Datei, bereinigst sie und zeichnest Diagramme |
| 4–6 | Statistik und lineare Algebra | Du rechnest Mittelwert, Streuung und Matrixprodukte selbst in NumPy |
| 7–10 | scikit-learn: Regression, Klassifikation, Clustering | Du trainierst drei Typen von Verfahren auf Übungsdaten |
| 11–12 | Evaluation | Du teilst die Werte in Training und Test und erkennst Overfitting |
| 13–15 | Eigenes Projekt | Ein kleines Vorhaben mit eigenem Datensatz, sauber dokumentiert |
| 16 | Ausblick Deep Learning | Du kennst neuronale Netzwerke und weißt, wie es weitergeht |
Schritt 1: NumPy und pandas als Werkzeugkasten
In der Praxis verbringst du mehr Zeit mit dem Aufbereiten von Daten als mit dem Training. Deshalb fängst du mit dem Handwerkszeug an. NumPy rechnet mit Arrays, also Vektoren und Matrizen, und ist dabei deutlich schneller als normale Python-Listen. pandas verwendet NumPy im Hintergrund und gibt dir Tabellen (DataFrames), mit denen du filterst, gruppierst und fehlende Werte findest.
Für praktische Übungen reicht ein Jupyter Notebook. Kostenlose Ressourcen für Übungsdaten sind das UCI-Repository der University of California, Irvine, und Kaggle. Übe drei Wochen lang die immer gleichen Handgriffe: laden, ansehen, bereinigen, darstellen. Das klingt unspektakulär. Es ist aber der Teil, an dem spätere Vorhaben am häufigsten scheitern.
Schritt 2: Statistik und lineare Algebra, nur das Nötige
Jetzt holst du die Mathe nach, und zwar direkt in Python. Rechne den Mittelwert einer Spalte einmal von Hand mit einer Schleife und einmal mit numpy.mean(). Multipliziere zwei kleine Matrizen auf Papier und prüfe das Ergebnis mit dem @-Operator. Wichtig ist, dass du Formel und Code nebeneinander siehst.
Der Haken: Mathe-Kurse für maschinelles Lernen sind oft zu breit. Halte dich an die Liste oben und spring weiter, sobald du die Begriffe erklären kannst. Lücken schließt du später, wenn Algorithmen sie verlangen. Für die Statistik gibt dir dann der Lernplan Statistik lernen für Data Science eine feste Reihenfolge.
Schritt 3: Klassische Verfahren mit scikit-learn
scikit-learn ist die Standardbibliothek für klassisches maschinelles Lernen in Python. Sie bündelt Dutzende Algorithmen hinter derselben Schnittstelle: Du erzeugst ein Objekt, rufst fit() mit Trainingsdaten auf und danach predict() für Vorhersagen auf neuen Werten. Diesen Prozess wiederholst du bei jedem Verfahren. Installiert ist die Bibliothek mit pip install scikit-learn, danach kannst du sie in jedem Notebook nutzen.
Welche Verfahren du für welche Aufgaben zuerst lernen solltest, zeigt die Tabelle:
| Verfahren | Lernform | Typische Aufgabe |
|---|---|---|
| Lineare Regression | überwacht | einen Zahlenwert schätzen, etwa den Preis einer Wohnung aus der Fläche |
| Logistische Regression | überwacht | Ja/Nein-Entscheidung, etwa ob eine Mail Spam ist |
| Entscheidungsbaum, Random Forest | überwacht | Klassifikation und Zahlenschätzung auf Tabellendaten mit nachvollziehbaren Regeln |
| k-nächste Nachbarn | überwacht | einen Datenpunkt der Klasse seiner ähnlichsten Nachbarn zuordnen |
| k-Means | unüberwacht | Gruppen ohne Beschriftung finden, etwa Kundensegmente |
| Hauptkomponentenanalyse (PCA) | unüberwacht | viele Merkmale auf wenige verdichten, damit komplexe Tabellen im Diagramm sichtbar werden |
Ein kurzes Codebeispiel mit dem Iris-Datensatz, der in scikit-learn mitgeliefert ist und in vielen Kursen verwendet wird: 150 Blüten aus drei Arten, je vier Messwerte.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y)

knn = KNeighborsClassifier(n_neighbors=5)
knn.fit(X_train, y_train)
y_pred = knn.predict(X_test)
print(accuracy_score(y_test, y_pred))
Der Klassifikator lernt mit drei Vierteln der Blüten und bestimmt die Art des restlichen Viertels. Ausgegeben wird die Genauigkeit, also der Anteil richtiger Vorhersagen zwischen 0 und 1. Der Kern ist also einfach. Zeit kostet vor allem das Aufbereiten der Daten davor.
Schritt 4: Evaluation, Train/Test und Overfitting
Ein Verfahren, das seine Trainingsdaten auswendig kennt, hilft dir bei neuen Fällen nicht weiter. Die scikit-learn-Dokumentation nennt es ausdrücklich einen methodischen Fehler, mit denselben Daten zu trainieren und zu testen, und beschreibt das Problem als Overfitting und dessen Vermeidung über eine Testmenge. Deshalb hältst du immer einen bestimmten Anteil zurück. train_test_split legt ohne weitere Angabe 25 Prozent beiseite.
In diesen zwei Wochen lernst du:
- Train/Test-Split und Kreuzvalidierung mit
cross_val_score - Metriken: Genauigkeit, Präzision, Recall, bei Zahlenwerten der mittlere absolute Fehler
- Overfitting erkennen: sehr gute Werte im Training, schwache im Test
- Gegenmittel: ein einfacheres Verfahren, mehr Daten, Regularisierung
Konkret heißt das: Vergleiche jede Zahl mit einer simplen Baseline. Wenn 90 Prozent deiner Mails kein Spam sind, erreicht ein Klassifikator, der immer „kein Spam“ sagt, schon 90 Prozent Trefferquote.
Schritt 5: Dein erstes eigenes Projekt
Nach zwölf Wochen hast du genug Werkzeug, um ein eigenes Projekt zu erstellen. Nimm Werte, die dich interessieren: Wetterdaten deiner Stadt, Mietpreise, Spielstände aus deinem Lieblingssport. Formuliere eine Frage, die ein Algorithmus beantworten kann, etwa: „Lässt sich der Stromverbrauch des nächsten Tages aus der Temperatur schätzen?“ So sammelst du Erfahrung mit echten, unordentlichen Daten.
Plane drei Wochen ein. Woche 13 für Daten und Bereinigung, Woche 14 für zwei oder drei Verfahren im Vergleich, Woche 15 für die Auswertung und eine kurze Dokumentation. Lade das Notebook auf GitHub hoch. Ein sauber erklärtes kleines Projekt sagt über deine Fähigkeiten oft mehr als ein Zertifikat.
Schritt 6: Ausblick auf Deep Learning
Deep Learning ist der Teil des maschinellen Lernens, der mit künstlichen neuronalen Netzen arbeitet. Seine typischen Anwendungen sind Bilder, Sprache und Text, also Computer Vision und NLP, und meist braucht es dafür große Datensätze. Für Tabellendaten sind die klassischen Verfahren aus Schritt 3 oft gleich gut und schneller trainiert.
Für ein erstes kleines Netz, das handgeschriebene Ziffern erkennt, kannst du in Woche 16 Keras oder PyTorch nutzen. Danach entscheidest du, ob du tiefer in Deep Learning einsteigst oder bei klassischen Verfahren bleibst. Wer noch eine weitere Sprache für den Werkzeugkasten sucht, findet Orientierung im Überblick Programmieren lernen.
Fachbücher für maschinelles Lernen im Porträt
Bücher geben dem Lernen eine feste Reihenfolge, das Üben ersetzen sie nicht. Neben kostenlosen Ressourcen wie Dokumentation und Übungsdaten lohnt deshalb ein Lehrbuch. Alle drei stehen auch in unserem Bücherregal mit Steckbriefen.
Hands-On Machine Learning with Scikit-Learn, Keras and TensorFlow von Aurélien Géron ist das Praxisbuch für diesen Lernweg. Der erste Teil behandelt klassische Verfahren mit scikit-learn, von einfachen linearen Verfahren bis zu Random Forests, der zweite neuronale Netze mit Keras und TensorFlow. Zum Buch gibt es Jupyter Notebooks zum Mitmachen. Die 3. Auflage ist 2023 auf Deutsch erschienen, unter dem Titel „Praxiseinstieg Machine Learning mit Scikit-Learn, Keras und TensorFlow“, übersetzt von Kristian Rother und Thomas Demmig. Niveau: mittel, Python-Grundlagen werden vorausgesetzt.
Machine Learning: An Algorithmic Perspective von Stephen Marsland geht einen anderen Weg. Statt Bibliotheken aufzurufen, baust du die Algorithmen selbst in Python mit NumPy nach. Die 2. Auflage erschien 2014 bei Chapman & Hall/CRC und ergänzte unter anderem Random Forests. Das Buch richtet sich an Studierende ohne starken Statistik-Hintergrund. Gut geeignet, wenn du verstehen willst, was in fit() eigentlich passiert.
Data Mining: Practical Machine Learning Tools and Techniques von Ian H. Witten, Eibe Frank, Mark A. Hall und Christopher J. Pal ist ein Klassiker aus dem Umfeld der Software Weka der University of Waikato. Die 4. Auflage erschien 2016 bei Morgan Kaufmann und umfasst rund 650 Seiten. Schwerpunkt sind die Algorithmen selbst und ihre saubere Bewertung. Ein Lehrbuch zum Nachschlagen, weniger zum Durchlesen am Stück.
Für den Einstieg würden wir Géron nehmen, weil es Code und Erklärung am engsten verbindet. Marsland lohnt sich parallel zu Schritt 3, Witten und Kollegen später als Referenz.
Kurz beantwortet
Kann ich maschinelles Lernen ohne Studium lernen?
Ja. Die Werkzeuge sind kostenlos, viele Kursunterlagen frei zugänglich. Für Forschungsstellen verlangen Arbeitgeber meist einen Abschluss, für viele Einstiegsjobs in Data Science helfen eigene Notebooks auf GitHub als Nachweis praktischer Erfahrung.
Wie lange dauert der Einstieg?
Mit Python-Grundlagen als Richtwert 16 Wochen bei etwa 5 Stunden pro Woche für die klassischen Verfahren. Spezialgebiete wie Bildverarbeitung kommen danach.
Worin unterscheiden sich klassische Verfahren und Deep Learning?
Tiefe Netzwerke erkennen Muster direkt in Rohdaten wie Pixeln, brauchen dafür aber meist mehr Daten und Rechenleistung. Bei klassischen Verfahren wählst du die Merkmale vorher selbst aus. Viele aktuelle Anwendungen der künstlichen Intelligenz, etwa Sprachmodelle, beruhen auf Deep Learning.