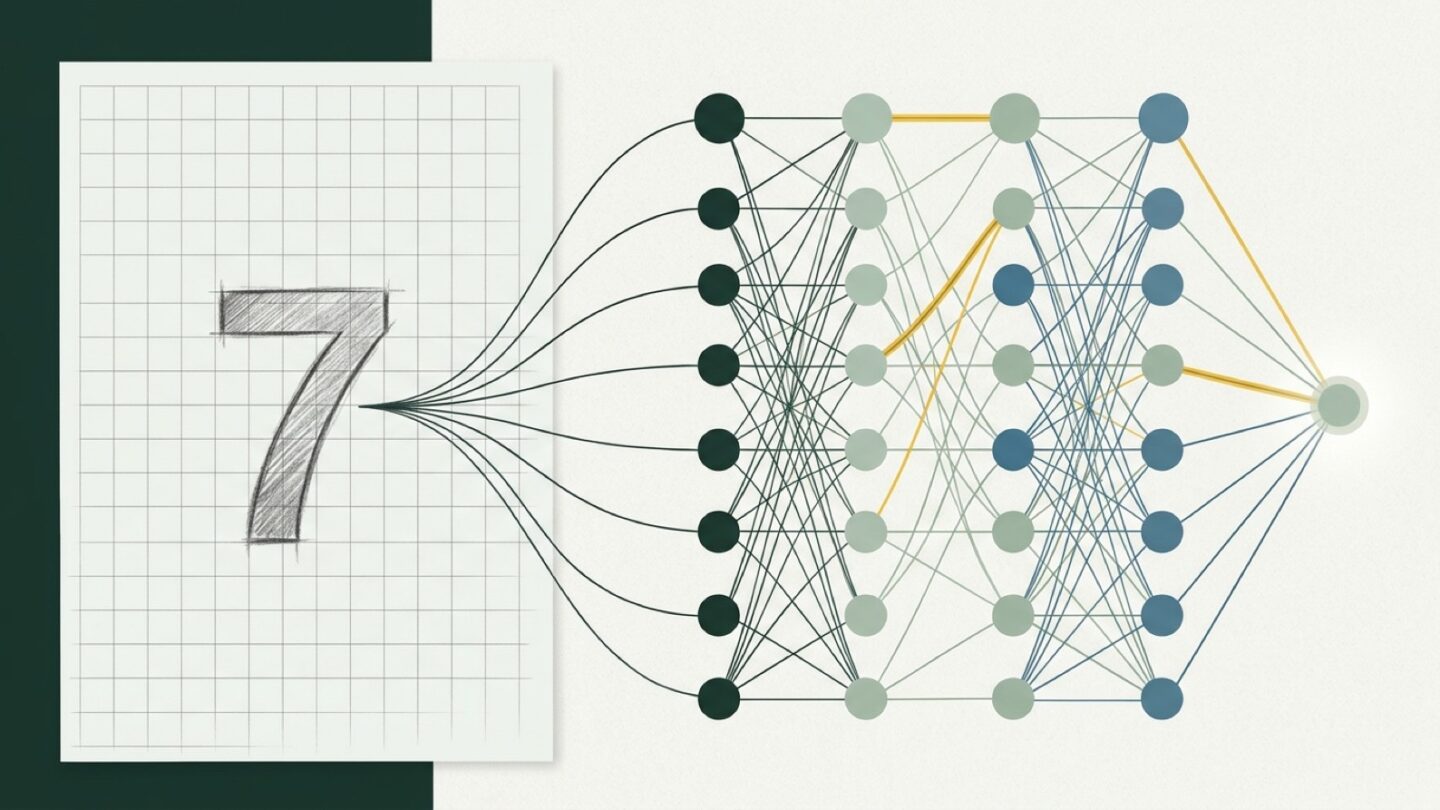
Eine handgeschriebene Sieben, eingescannt als Bild mit 28 mal 28 Pixeln. Für dich ist die Ziffer sofort klar, für einen Computer sind es 784 Zahlen zwischen 0 und 255. Wie ein Programm daraus „7“ macht, ohne dass jemand Regeln für Striche und Bögen schreibt, ist der Kern von Deep Learning: Ein künstliches neuronales Netzwerk lernt die Regeln selbst aus den Daten. Genau an diesem Beispiel erklären wir hier die Bausteine: Neuron, Schichten, Aktivierungsfunktion, Verlustfunktion und Backpropagation. Danach folgen Architekturen, Frameworks, ein kleines Codebeispiel zum Mitmachen und zwei Bücher.
Das Beispiel ist kein Zufall. Der MNIST-Datensatz mit 60.000 Trainings- und 10.000 Testaufnahmen handgeschriebener Ziffern ist seit den 1990er-Jahren das typische Übungsfeld für tiefe neuronale Netze. Fast jedes Lehrbuch fängt hier an.
Vom Pixel zum Neuron: was in den Schichten passiert
Ein künstliches Neuron ist eine kleine Rechenregel, lose angelehnt an die Nervenzellen des menschlichen Gehirns. Es nimmt die Informationen aus der vorherigen Schicht, multipliziert jeden Wert mit einem Gewicht, addiert alles und schlägt einen festen Wert drauf, den Bias. Das Ergebnis geht durch eine Aktivierungsfunktion und wird an die nächste Schicht weitergereicht.
Für MNIST sieht ein einfaches neuronales Netzwerk so aus:
- Eingabeschicht: 784 Werte, ein Wert pro Pixel.
- Verborgene Schicht: zum Beispiel 128 Einheiten, jede mit allen 784 Pixeln verbunden.
- Ausgabeschicht: 10 Ausgänge, einer pro Ziffer von 0 bis 9.
Schon dieses kleine Netzwerk hat 101.770 Parameter: 784 mal 128 Verbindungen plus 128 Bias-Werte in der ersten Schicht, dazu 128 mal 10 Verbindungen plus 10 Bias-Werte in der zweiten. Diese Parameter kennt am Anfang niemand. Sie werden zufällig gesetzt und dann gelernt.
„Deep“ heißt nur: Es gibt mehrere verborgene Ebenen hintereinander. Daher die Tiefe im Namen. Die vorderen Schichten reagieren eher auf einfache Merkmale wie Kanten, die hinteren auf Kombinationen daraus, etwa einen geschlossenen Bogen oder einen Querstrich. Das System baut sich seine Merkmale selbst, statt sie von einem Menschen vorgegeben zu bekommen. Das ist der entscheidende Unterschied zu klassischen Verfahren, bei denen du die Merkmale oft von Hand auswählst. Der Preis dafür: Tiefe Modelle brauchen große Datenmengen, bevor sie verlässlich arbeiten.
Warum tiefe Netze eine Aktivierungsfunktion brauchen
Ohne Aktivierungsfunktion wäre jede Schicht nur eine lineare Rechnung. Stapelst du zehn solcher Schichten, ergibt sich mathematisch wieder eine einzige lineare Funktion. Das Modell könnte dann nur gerade Trennlinien ziehen. Eine Sieben von einer Eins zu unterscheiden, gelingt so schlecht.
Die Aktivierungsfunktion bringt den Knick hinein. Die heute verbreitetste ist ReLU: Negative Werte werden zu 0, positive bleiben, wie sie sind. Klingt banal. Es reicht aber, damit viele Schichten zusammen komplexe Funktionen und Strukturen in den Daten abbilden. In der Ausgabeschicht kommt für Klassifikation meist Softmax dazu. Sie macht aus den zehn Rohwerten Wahrscheinlichkeiten, die zusammen 1 ergeben, etwa 0,91 für die Sieben und 0,05 für die Eins.
Wie Deep Learning aus Fehlern lernt
Am Anfang rät das Modell. Zeigt es bei unserer Sieben 0,12 statt 0,91, misst die Verlustfunktion, wie weit es danebenliegt. Bei Klassifikation ist das meist die Kreuzentropie, bei Zahlenwerten oft der mittlere quadratische Fehler.
Das Training läuft dann in vier Schritten, immer wieder:
- Forward Pass: Ein Stapel Beispiele läuft durch alle Schichten, am Ende stehen Vorhersagen.
- Verlust berechnen: Die Verlustfunktion vergleicht Vorhersage und richtige Ziffer.
- Backpropagation: Mit der Kettenregel der Ableitung wird rückwärts berechnet, wie stark jedes Gewicht zum Fehler beigetragen hat. Das Ergebnis heißt Gradient.
- Gradientenabstieg: Jedes Gewicht wird ein kleines Stück in die Richtung verschoben, die den Fehler senkt. Wie groß der Schritt ist, legt die Lernrate fest.
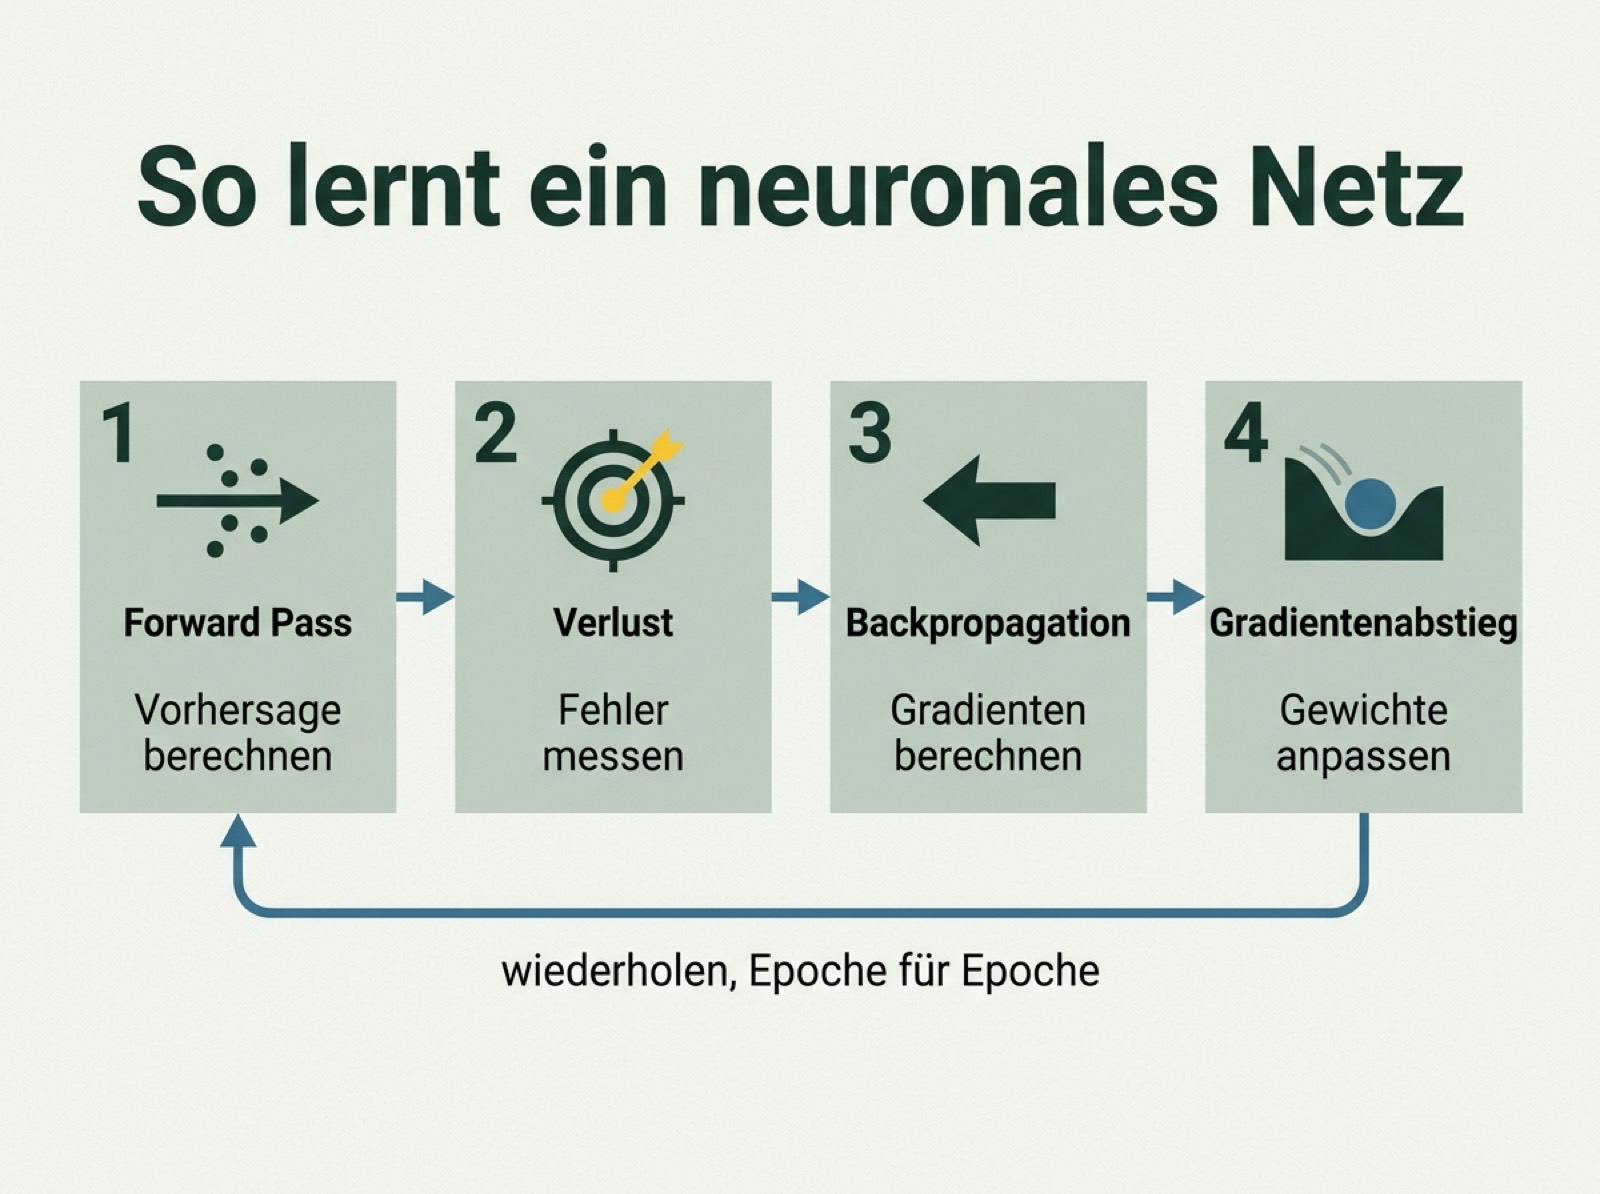
Ein Durchlauf durch alle Trainingsdaten heißt Epoche. Bei MNIST sind es 60.000 Aufnahmen pro Epoche, meist in Stapeln zu 32 oder 64. Der Haken: Ist die Lernrate zu hoch, springt das Verfahren über das Ziel hinaus. Ist sie zu niedrig, dauert das Training ewig. Die Variante mit zufälligen kleinen Stapeln heißt Stochastic Gradient Descent, kurz SGD. Optimierer wie Adam passen die Schrittweite zusätzlich selbst an.
Selbst ausprobieren: ein Mini-Netz für XOR mit NumPy
Bevor du ein Framework installierst, lohnt ein Modell, bei dem du jede Zeile siehst. XOR ist das klassische Beispiel: Die Ausgabe ist 1, wenn genau eine der beiden Eingaben 1 ist. Eine einzelne lineare Schicht schafft das nicht, eine verborgene Schicht mit vier Neuronen schon. In der verborgenen Schicht steckt tanh, eine weitere Aktivierungsfunktion mit Werten zwischen −1 und 1. Du brauchst nur Python und NumPy.
import numpy as np

rng = np.random.default_rng(42)
X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)
y = np.array([[0], [1], [1], [0]], dtype=float)

W1 = rng.normal(size=(2, 4))   # Eingabe -> 4 versteckte Neuronen
b1 = np.zeros((1, 4))
W2 = rng.normal(size=(4, 1))   # versteckt -> 1 Ausgabe
b2 = np.zeros((1, 1))
sigmoid = lambda z: 1 / (1 + np.exp(-z))
lr = 1.0

for epoch in range(5001):
    # Forward Pass
    h = np.tanh(X @ W1 + b1)
    p = sigmoid(h @ W2 + b2)
    loss = np.mean((p - y) ** 2)
    # Backpropagation
    d_out = 2 * (p - y) / len(X) * p * (1 - p)
    d_h = (d_out @ W2.T) * (1 - h ** 2)
    # Gradientenabstieg
    W2 -= lr * h.T @ d_out
    b2 -= lr * d_out.sum(axis=0, keepdims=True)
    W1 -= lr * X.T @ d_h
    b1 -= lr * d_h.sum(axis=0, keepdims=True)
    if epoch % 1000 == 0:
        print(f"Epoche {epoch:4d}  Verlust {loss:.4f}")

print(np.round(p.ravel(), 3))
Mit Python 3.13 und NumPy 2.4 liefert das Skript diese Ausgabe:
Epoche    0  Verlust 0.2874
Epoche 1000  Verlust 0.0010
Epoche 2000  Verlust 0.0004
Epoche 3000  Verlust 0.0002
Epoche 4000  Verlust 0.0002
Epoche 5000  Verlust 0.0001
[0.005 0.987 0.989 0.014]
Der Verlust fällt von 0,29 auf 0,0001, und die vier Vorhersagen liegen nah an 0, 1, 1, 0. Alle vier Schritte aus dem Kapitel davor stehen hier im Klartext. Ändere ruhig die Lernrate auf 0.01 oder die Zahl der Neuronen auf 2 und schau, was passiert.
Die wichtigsten Architekturen im Überblick
Nicht jede Aufgabe passt zu einem einfachen Netz aus vollständig verbundenen Schichten. Je nach Datentyp haben sich andere Architekturen durchgesetzt, die die Informationen unterschiedlich verarbeiten:
| Architektur | Wofür sie gut ist | Typisches Beispiel |
|---|---|---|
| MLP (Multilayer Perceptron) | Tabellen, kleine Bilder, Einstieg | Ziffern aus MNIST erkennen |
| CNN (Convolutional Neural Network) | Fotos und Videos, lokale Muster | Fotos sortieren, Schäden auf Röntgenbildern markieren |
| RNN / LSTM (Recurrent Neural Networks, Long Short-Term Memory) | Sequenzen mit Reihenfolge | Sensordaten, ältere Spracherkennung |
| Transformer | Text, Sprache, inzwischen auch Bilder | Übersetzung, Sprachmodelle hinter Chatbots |
Convolutional Neural Networks (CNNs) schieben kleine Filter über das Bild und erkennen so Kanten und Formen unabhängig davon, wo sie stehen. Yann LeCuns LeNet-5 von 1998 las damit schon Ziffern auf Schecks. Recurrent Neural Networks (RNNs) verarbeiten eine Folge Schritt für Schritt und geben einen Zwischenstand weiter. Die LSTM stellten Sepp Hochreiter und Jürgen Schmidhuber 1997 vor, um diesen Speicher über lange Sequenzen zu halten. Transformer gehen auf das Paper „Attention Is All You Need“ von 2017 zurück und verarbeiten alle Wörter eines Satzes parallel, statt eines nach dem anderen.
PyTorch oder TensorFlow?
Beide Frameworks erledigen im Kern dasselbe: Sie rechnen mit Tensoren und bilden die Gradienten automatisch, auf Wunsch auf der Grafikkarte.
- PyTorch stammt aus der KI-Forschung von Meta und gehört seit 2022 zur PyTorch Foundation unter dem Dach der Linux Foundation. Der Code liest sich wie normales Python, Fehler lassen sich Zeile für Zeile debuggen. In der Forschung ist es heute der Standard.
- TensorFlow kommt von Google und ist seit 2015 öffentlich. Einsteiger nutzen es meist über Keras, eine Schicht darüber, mit der ein Modell in wenigen Zeilen steht. Seit Keras 3 läuft dieselbe Keras-API auch auf PyTorch und JAX.
Für den Anfang würden wir PyTorch nehmen, weil die meisten aktuellen Tutorials und der Code zu Forschungsarbeiten darauf setzen. Wer lieber schnell ein erstes Ergebnis sieht, ist mit Keras gut bedient. Der Wechsel später ist kleiner, als er wirkt, denn die Konzepte sind dieselben.
Was du vorher können solltest und welche Hardware reicht
Tiefe neuronale Netze sind kein Einstiegsthema. Du brauchst sicheres Python, NumPy und die Grundideen des maschinellen Lernens: Trainings- und Testdaten, Overfitting, Bewertung eines Modells. Mathematisch reichen Vektoren und Matrizen, Ableitungen und etwas Wahrscheinlichkeitsrechnung.
Auf Lernsafari findest du dafür drei aufeinander aufbauende Pläne, jeweils als Richtwert bei etwa 5 Stunden pro Woche. Der Lernweg für Python in 12 Wochen legt das Fundament. Danach folgt Machine Learning lernen in 16 Wochen. Der KI-Lernpfad über 24 Wochen verbindet beides und sieht für Deep Learning die Wochen 19 bis 24 vor, also rund 30 Stunden für die ersten eigenen Netze.
Und die Grafikkarte? Für MNIST und kleine Modelle genügt die CPU eines normalen Laptops, ein Training dauert dann wenige Minuten. Eine GPU lohnt sich, sobald die Eingaben größer werden oder du mit Transformern arbeitest. Konkret heißt das:
- Ohne eigene GPU: Google Colab und Kaggle bieten Notebooks mit Grafikkarte kostenlos an, mit Zeitlimits.
- Nvidia-Karte: PyTorch und TensorFlow nutzen sie über CUDA. Der Speicher der Grafikkarte begrenzt, wie groß Modell und Stapel sein dürfen.
- Mac mit Apple-Chip: PyTorch kann die GPU über das Backend MPS ansprechen.
Große Sprachmodelle von Grund auf zu trainieren, braucht Rechenzentren mit Tausenden Grafikkarten. Das ist kein Ziel für ein Lernprojekt. Ein vortrainiertes Modell mit Transfer Learning an eigene Daten anzupassen, schaffst du dagegen oft schon in Colab.
Zwei Bücher, die den Stoff tragen
Deep Learning
Ian Goodfellow, Yoshua Bengio und Aaron Courville haben das Standardwerk zur Theorie geschrieben. Es erschien 2016 bei MIT Press, die Online-Fassung des Buchs ist laut Autoren vollständig und bleibt kostenlos verfügbar. Der erste Teil wiederholt lineare Algebra, Wahrscheinlichkeitsrechnung und numerische Berechnung, danach folgen Feedforward-Netze, Regularisierung, Optimierung, CNNs und Sequenzmodelle. Auf Deutsch erschien es 2018 bei mitp als „Deep Learning. Das umfassende Handbuch“. Niveau: fortgeschritten. Es passt, wenn du verstehen willst, warum die Verfahren funktionieren.
Deep Learning with Python
François Chollet hat die Bibliothek Keras entwickelt. Die dritte Auflage schrieb er zusammen mit Matthew Watson, sie erschien 2025 bei Manning. Neu sind Kapitel zur Transformer-Architektur, zum Bau eines kleinen Sprachmodells nach GPT-Vorbild und zur Bildgenerierung mit Diffusionsmodellen. Vorausgesetzt wird mittleres Python, Vorwissen in maschinellem Lernen oder linearer Algebra laut Verlag nicht. Die deutsche Ausgabe „Deep Learning mit Python und Keras“ von 2018 bei mitp beruht auf der ersten Auflage. Niveau: Einstieg bis mittel, sehr praxisnah.
Weitere Steckbriefe zu Fachbüchern rund um Daten und KI findest du im Lernsafari-Bücherregal.
Kurz beantwortet
Was ist der Unterschied zwischen Machine Learning und Deep Learning?
Deep Learning ist ein Teilbereich des maschinellen Lernens. Gemeint sind Netzwerke aus vielen Schichten, die ihre Merkmale selbst aus den Rohdaten lernen. Klassische Verfahren wie Entscheidungsbäume brauchen meist vorbereitete Merkmale und weniger Daten.
Wie lange dauert es, Deep Learning zu lernen?
Mit Python-Grundlagen und Vorwissen aus dem maschinellen Lernen sind die ersten eigenen Modelle in etwa sechs Wochen realistisch, als Richtwert bei 5 Stunden pro Woche. Von null an rechnest du mit den 24 Wochen des KI-Lernpfads.
Brauche ich eine GPU?
Für den Anfang nicht. MNIST trainiert auch auf der CPU, und für größere Modelle reichen kostenlose Cloud-Notebooks mit Zeitlimit.