Für den Anfang reicht eine Funktion mit sechs Zeilen. Sie rechnet aus, wie viele Minuten ein Text zum Lesen braucht. An diesem Beispiel lernst du Unit Testing: Wir erstellen den ersten Test, prüfen Grenzfälle, ersetzen eine API durch einen Mock und spielen einmal den TDD-Zyklus durch. Alle Ausgaben stammen aus einem echten Lauf mit Python 3.13 und pytest 9.2.
# lesezeit.py
import math


def lesezeit(woerter, wpm=200):
    """Lesezeit in ganzen Minuten, aufgerundet."""
    if woerter < 0:
        raise ValueError("Wortzahl darf nicht negativ sein")
    return math.ceil(woerter / wpm)
Ein Unit-Test prüft so eine kleinste Einheit isoliert, also Funktion, Methode oder Klasse. Im ISTQB-Lehrplan und in deutschen Lehrbüchern heißt dieselbe Teststufe Komponententest. Gemeint sind die kleinsten testbaren Teile der Anwendung: Einzelne Komponenten werden separat getestet, bevor sie mit anderen Einheiten der Software zusammenspielen. Wer Python noch nicht sicher liest, holt sich die Grundlagen am besten zuerst über unseren Plan zum Python lernen.
Vorab: Wo Unit-Tests in der Testpyramide stehen
Die Testpyramide ordnet automatisierte Tests nach Umfang. Unten liegen viele kleine und schnelle, oben wenige große. Die Prozentwerte sind eine verbreitete Faustregel für Entwickler, kein Gesetz.
| Ebene | Was geprüft wird | Geschwindigkeit | Anteil (Richtwert) |
|---|---|---|---|
| Unit-Test | einzelne Einheiten wie Funktion oder Klasse, ohne Netz und Datenbank | Millisekunden | ca. 70 % |
| Integrationstest | Zusammenspiel mehrerer Module, z. B. Code plus Datenbank oder API | Sekunden | ca. 20 % |
| End-to-End- bzw. Systemtest | die ganze Anwendung aus Sicht des Nutzers, oft per Browser | Sekunden bis Minuten | ca. 10 % |
Der Grund für die Form ist schlicht: Ein Unit-Test schlägt genau dort fehl, wo der Fehler steckt. Systemtests melden dir nur, dass irgendwo zwischen Login und Datenbank etwas klemmt. Für die frühzeitige Erkennung von Fehlern sind die kleinen Tests unten deshalb am wertvollsten. Sie liefern schnelles Feedback, oft schon beim Speichern der Datei.
Schritt 1: Der erste Test mit pytest
pytest installierst du mit pip install pytest, am besten in einer virtuellen Umgebung. Danach legst du neben lesezeit.py eine Datei test_lesezeit.py an. Der Name ist kein Zufall: Das Werkzeug sammelt laut seiner Dokumentation zur Test-Erkennung Dateien nach dem Muster test_*.py oder *_test.py und darin alles, was mit test beginnt.
# test_lesezeit.py
from lesezeit import lesezeit


def test_lesezeit_rundet_auf():
    assert lesezeit(450) == 3
Mehr braucht es nicht. Ein einfaches assert genügt, ein Klassengerüst ist überflüssig. Um Code testen zu können, brauchst du anfangs nicht mehr. Der Aufruf mit -v im Projektordner liefert (Kopfzeilen gekürzt):
collected 1 item

test_lesezeit.py::test_lesezeit_rundet_auf PASSED                        [100%]

============================== 1 passed in 0.01s ===============================
Das eingebaute Modul unittest kann dasselbe, verlangt aber eine class und Methoden wie assertEqual:
import unittest

from lesezeit import lesezeit


class TestLesezeit(unittest.TestCase):
    def test_rundet_auf(self):
        self.assertEqual(lesezeit(450), 3)
Für neue Projekte würden wir pytest verwenden. Die Tests fallen kürzer aus, und vorhandene unittest-Klassen laufen damit weiter: Im Probelauf kam für die Klasse oben 1 passed heraus.
Schritt 2: Arrange, Act, Assert
Sobald ein Test mehr als eine Zeile hat, hilft eine feste Ordnung. Arrange-Act-Assert (AAA) teilt ihn in drei Blöcke: Daten vorbereiten, den Code einmal aufrufen, das Ergebnis überprüfen.
def test_langer_artikel_mit_schnellem_leser():
    # Arrange
    woerter = 1500
    tempo = 300
    # Act
    minuten = lesezeit(woerter, wpm=tempo)
    # Assert
    assert minuten == 5
Die Kommentare kannst du später weglassen, die Leerzeilen solltest du behalten. Der Haken an AAA: Es verführt dazu, im Assert-Block fünf Dinge auf einmal zu prüfen. Wir halten uns an eine Regel aus den üblichen Best Practices: ein Verhalten pro Test. Schlägt er fehl, sagt dir schon sein Name, welche Funktionalität kaputt ist.
Schritt 3: Grenzfälle und Fehlerfälle
Die meisten Fehler sitzen an Rändern. Bei der Lesezeit sind das 0 Wörter, 1 Wort und genau die Grenze von 200 Wörtern pro Minute. Mit parametrize schreibst du dafür einen Test mit mehreren Eingaben statt vier fast gleicher Kopien.
import pytest


@pytest.mark.parametrize("woerter, erwartet", [
    (0, 0),
    (1, 1),
    (200, 1),
    (201, 2),
])
def test_grenzwerte(woerter, erwartet):
    assert lesezeit(woerter) == erwartet


def test_negative_wortzahl_wirft_fehler():
    with pytest.raises(ValueError, match="negativ"):
        lesezeit(-5)
Der Fehlerfall gehört genauso dazu: raises überprüft, dass der Code bei Unsinn eine Exception wirft. Zusammen mit den bisherigen Beispielen meldet der Lauf mit -q sieben Punkte, weil jede Parameterzeile als eigener Test zählt:
.......                                                                  [100%]
7 passed in 0.01s
Eine Frage bleibt offen: Was passiert bei einem Lesetempo von 0? Dazu gleich in Schritt 5.
Schritt 4: Test-Doubles und Mocks sparsam einsetzen
Komplizierter wird es, sobald deine Software Daten von außen holt. Angenommen, eine zweite Hilfsroutine lädt den Artikeltext über eine API:
def lesezeit_fuer_artikel(slug, api):
    text = api.hole_text(slug)
    return lesezeit(len(text.split()))
Im Unit-Test willst du keine echten Requests ins Netz. Hier hilft ein Test-Double, ein Platzhalter für die echte Abhängigkeit. Pythons unittest.mock.Mock liefert einen vorgegebenen Rückgabewert und merkt sich, wie er aufgerufen wurde. Eine Fixture erstellt ihn frisch für jeden Test:
from unittest.mock import Mock

import pytest


@pytest.fixture
def api():
    api = Mock()
    api.hole_text.return_value = "wort " * 450
    return api


def test_lesezeit_fuer_artikel(api):
    assert lesezeit_fuer_artikel("erster-artikel", api) == 3


def test_api_wird_genau_einmal_gefragt(api):
    lesezeit_fuer_artikel("erster-artikel", api)
    api.hole_text.assert_called_once_with("erster-artikel")
Das funktioniert nur, weil api als Parameter hereinkommt. Was seine Abhängigkeiten selbst erzeugt, lässt sich schwer überprüfen; das ist oft das erste Zeichen für ein Designproblem. Nach demselben Prinzip ordnet die Clean Architecture ein ganzes Projekt: Die Fachlogik kennt nur Schnittstellen, Datenbank und Netz kommen von außen dazu.
Mocks bitte sparsam verwenden. Wer jede Kleinigkeit ersetzt, prüft am Ende nur noch, ob die Mocks so reagieren, wie er sie eingestellt hat. Unsere Faustregel:
- Ersetzen, was langsam oder unberechenbar ist: Netz, Datenbank, Uhrzeit, Zufall.
- Eigene, reine Funktionen wie
lesezeit()nie mocken, sondern echt aufrufen. - Aufrufe nur kontrollieren, wenn der Aufruf selbst das Verhalten ist, etwa „schickt genau eine Mail“.
Schritt 5: TDD mit Rot, Grün, Refactor
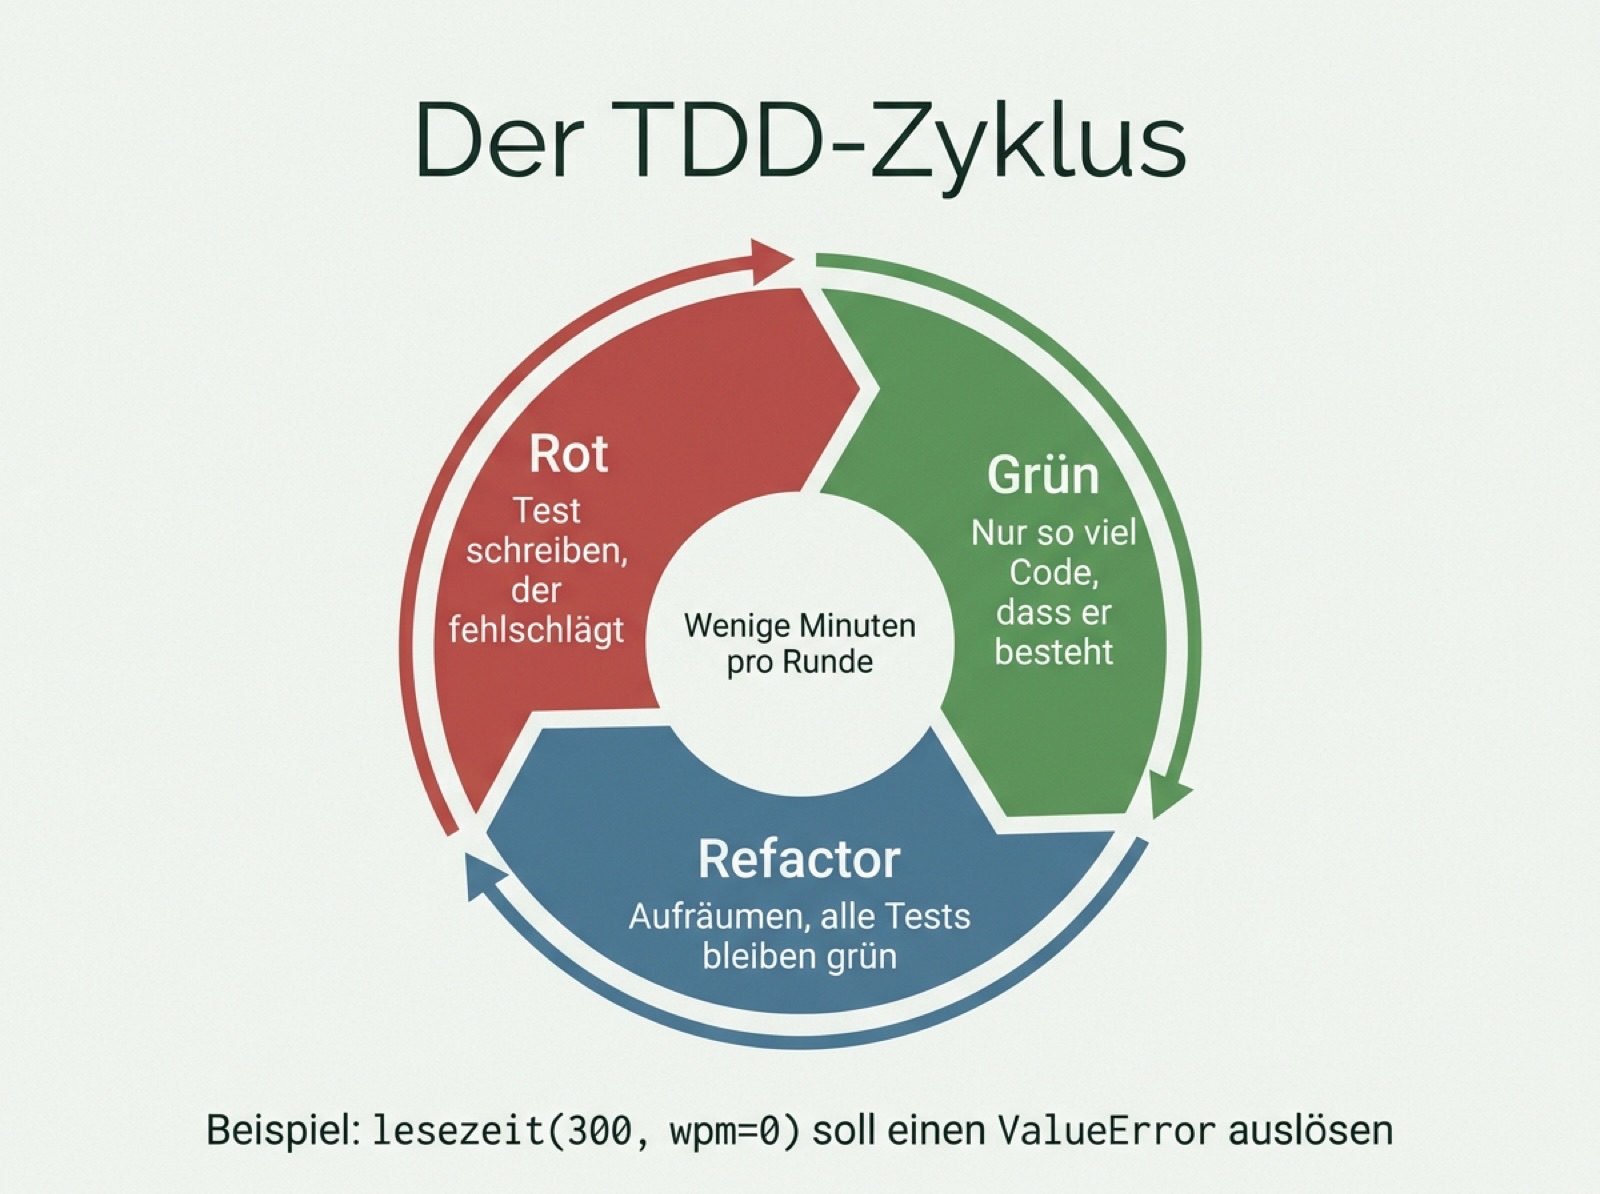
Test-Driven Development dreht die Reihenfolge um: Der Test entsteht vor der Implementierung. Der Zyklus hat drei Phasen.
- Rot: einen Test erstellen, der das gewünschte Verhalten beschreibt und fehlschlägt.
- Grün: gerade so viel Code ergänzen, dass er besteht.
- Refactor: aufräumen, während alles grün bleibt.
Die offene Frage aus Schritt 3 eignet sich gut. Ein Tempo von 0 soll einen verständlichen ValueError auslösen. Erst die Erwartung:
def test_tempo_null_wirft_fehler():
    with pytest.raises(ValueError, match="Lesetempo"):
        lesezeit(300, wpm=0)
Der nächste Lauf meldet Rot, und zwar mit einer anderen Exception als erwartet (gekürzt):
>       return math.ceil(woerter / wpm)
E       ZeroDivisionError: division by zero

lesezeit.py:8: ZeroDivisionError
1 failed, 7 passed in 0.02s
Für Grün reichen zwei Zeilen mehr in lesezeit():
def lesezeit(woerter, wpm=200):
    """Lesezeit in ganzen Minuten, aufgerundet."""
    if woerter < 0:
        raise ValueError("Wortzahl darf nicht negativ sein")
    if wpm <= 0:
        raise ValueError("Lesetempo muss größer als 0 sein")
    return math.ceil(woerter / wpm)
Danach: 8 passed in 0.00s. Beim Refactor gibt es hier wenig zu tun. In echten Projekten ist das die Phase, in der du Namen verbesserst und Dopplungen zusammenziehst. Änderungen am Code sind dann kein großes Risiko mehr, weil jede Regression sofort auffällt. Viele Probleme fallen so auf, bevor ein User sie bemerkt.
Unit Testing im Team: CI und realistische Abdeckung
Ein Test hilft nur, wenn er läuft. Im Team heißt das: Eine CI-Pipeline (Continuous Integration) startet die Suite bei jedem Push oder Pull Request, und gemergt wird nur, wenn alles grün ist. Weil Unit-Tests in Millisekunden laufen, kostet das kaum Wartezeit. So erkennen Entwicklerinnen und Entwickler Probleme, bevor sie in der Anwendung landen.
Die Testabdeckung misst, welche Zeilen beim Lauf ausgeführt wurden. Mit dem Plugin pytest-cov sieht das für alle zehn Tests so aus:
$ pytest -q --cov=lesezeit --cov-report=term-missing
Name          Stmts   Miss  Cover   Missing
-------------------------------------------
lesezeit.py      10      0   100%
-------------------------------------------
TOTAL            10      0   100%
10 passed in 0.06s
100 Prozent sehen gut aus, beweisen aber wenig. Die Zahl sagt nur, dass jede Zeile einmal lief. Ob 0 Wörter wirklich 0 Minuten ergeben sollen oder lieber „unter einer Minute“, entscheidet kein Werkzeug. Das klären die funktionalen Anforderungen. Wir würden die Abdeckung als Suchhilfe nutzen: Die Spalte Missing zeigt Zeilen, die noch nie getestet wurden. Eine harte Quote wie 80 Prozent als Merge-Bedingung führt dagegen gern zu Tests, die Zeilen ausführen und nichts überprüfen.
Seitenblick: JUnit 5 für Java
In Java ist JUnit 5 der verbreitete Standard. Das Prinzip bleibt gleich, nur sind Tests hier Methoden mit der Annotation @Test, und statt assert nutzt du assertEquals und assertThrows:
import static org.junit.jupiter.api.Assertions.*;
import org.junit.jupiter.api.Test;

class LesezeitTest {

    @Test
    void rundetAuf() {
        assertEquals(3, Lesezeit.minuten(450));
    }

    @Test
    void negativeWortzahlWirftFehler() {
        assertThrows(IllegalArgumentException.class, () -> Lesezeit.minuten(-5));
    }
}
Für Mocks nehmen Java-Entwickler meist Mockito. Die Regeln aus Schritt 4 gelten dort genauso.
Woran du gute Unit-Tests erkennst
Robert C. Martin fasst in „Clean Code“ die Eigenschaften guter Unit Tests unter dem Kürzel F.I.R.S.T. zusammen. Unser Artikel zu Clean Code zeigt, wie das Buch Tests als Teil sauberer Software behandelt. Unsere Einschätzung: Testfälle erstellen Entwickler am besten selbst, zusammen mit der Funktionalität, die sie gerade bauen.
- Schnell: Hunderte Tests laufen in wenigen Sekunden. Unsere zehn brauchten 0,06 Sekunden, inklusive Abdeckungsmessung.
- Unabhängig: Gute Tests sind unabhängig voneinander. Die Reihenfolge darf keine Rolle spielen.
- Wiederholbar: Gleiches Ergebnis auf deinem Laptop, beim Kollegen und in der CI. Uhrzeit und Zufall gehören deshalb hinter ein Test-Double.
- Selbstprüfend: Das Ergebnis heißt bestanden oder fehlgeschlagen, ohne dass jemand eine Ausgabe liest.
- Rechtzeitig: Der Test entsteht zusammen mit dem Feature, nicht Wochen später.
Bücher zum Weiterlesen
„Basiswissen Softwaretest“ von Andreas Spillner und Tilo Linz ist das deutschsprachige Lehrbuch zum ISTQB Certified Tester Foundation Level. Die 7., überarbeitete Auflage ist 2024 bei dpunkt erschienen und hat rund 390 Seiten. Es geht weit über Unit-Tests hinaus: Teststufen von der Komponente bis zum Systemtest, Testverfahren, Testmanagement, auch funktionale und nicht-funktionale Tests. Wer das Testen von Software als eigenes Fach verstehen will, legt damit das Fundament.
Speziell zu Unit-Tests gibt es von Vladimir Khorikov „Unit Testing: Principles, Practices, and Patterns“ (Manning, 2020, auf Englisch). Das Buch behandelt vor allem, wann Mocks schaden und welche Tests sich langfristig lohnen. Weitere Titel mit Steckbrief findest du im Lernsafari-Bücherregal.
Kurz beantwortet
Ist Komponententest dasselbe wie Unit-Test? In der ISTQB-Terminologie ja, beide Begriffe bezeichnen dieselbe Teststufe.
pytest oder unittest? Für neue Python-Projekte pytest, weil der Testcode kürzer ausfällt. unittest ist ohne Installation dabei und reicht für kleine Skripte.
Wie viele Unit Tests brauche ich? Für jede Einheit mindestens drei Testfälle: einen Normalfall, die Grenzwerte und einen Fehlerfall. In unserem Beispiel kamen auf zehn Anweisungen zehn Tests.