Wie holst du aus einer XML-Datei mit vier Büchern genau die drei, die nach 2020 erschienen sind? Mit XQuery reicht dafür eine Zeile. Die Abfragesprache des World Wide Web Consortium (W3C) sucht Knoten in einem XML-Dokument heraus und baut aus ihnen neue Ergebnisse, vom einzelnen Wert bis zur fertigen HTML-Liste. Wer schon etwas SQL kennt, findet sich schnell zurecht. In diesem Tutorial arbeitest du durchgehend mit einem kleinen Bücherkatalog. Jede Ausgabe kannst du selbst nachprüfen.
XQuery, XPath, XSLT und SQL im Vergleich
Rund um XML ist eine ganze Familie von Standards und Schnittstellen entstanden: XML, DTD, XML-Schema, XPath, XQuery, XSLT, XSL-FO, SAX und DOM. Drei davon fallen zusammen mit SQL oft in einem Atemzug, obwohl jede etwas anderes leistet.
| Sprache | Zweck | Ergebnis | Typischer Einsatz |
|---|---|---|---|
| XPath | Knoten in einem XML-Baum adressieren | Knoten oder einzelne Werte | Baustein in XSLT, Prüfregeln, Konfigurationen |
| XQuery | XML abfragen, filtern, sortieren, neu zusammensetzen | Sequenz aus Werten, Knoten oder neuem XML/HTML | XML-Datenbanken wie BaseX und eXist-db, Dokumentenarchive |
| XSLT | ein ganzes Dokument per Regeln umformen | neues Dokument (XML, HTML, Text) | Publishing-Strecken, XML zu HTML oder PDF-Vorstufe |
| SQL | Tabellen relationaler Datenbanken abfragen | Tabelle aus Zeilen und Spalten | MySQL, PostgreSQL, Microsoft SQL Server |
Konkret heißt das: XPath ist das Fundament. XQuery 3.1 erweitert XPath 3.1, darum ist jeder XPath-Ausdruck schon eine gültige Query. XSLT denkt in Vorlagen für ein komplettes Dokument, XQuery-Ausdrücke eher in Fragen an einen Datenbestand.
Für den Einstieg würden wir XQuery vor XSLT nehmen. Die Syntax erinnert an eine SELECT-Abfrage, und nach einer Stunde siehst du erste Treffer. Der Haken: Wer große Dokumente nur umformen will, ist mit XSLT oft besser bedient.
XML in Kürze: Elemente, Attribute, Knoten
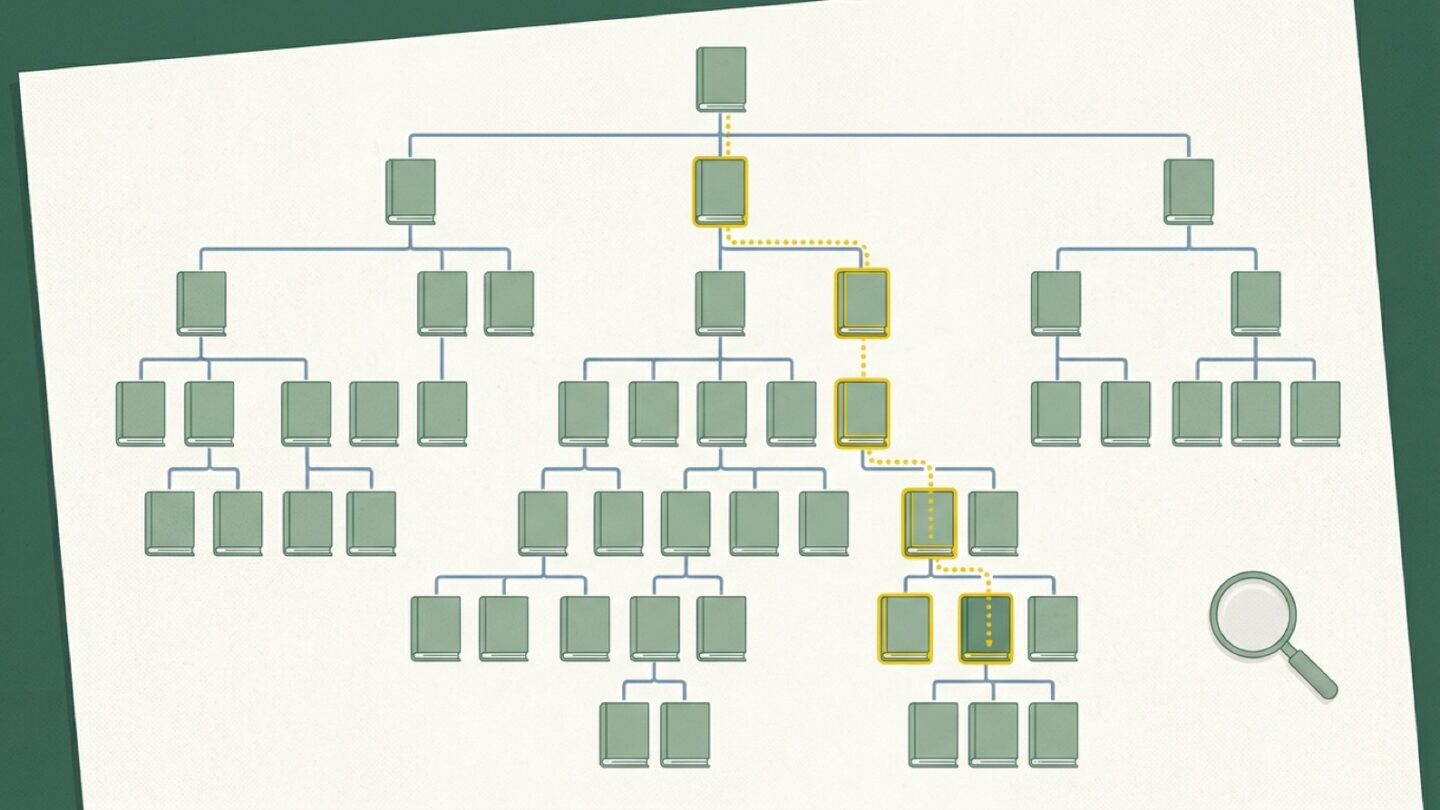
XML speichert Daten als Baum. Ein Element steht zwischen Start- und End-Tag, Attribute hängen am Start-Tag. Jedes Stück dieses Baums heißt Knoten. Das folgende XML-Dokument dient als Beispiel, gespeichert als katalog.xml:
<katalog>
  <buch id="b1" jahr="2019">
    <titel>XML im Alltag</titel>
    <autor>Lena Brandt</autor>
    <umfang>240</umfang>
    <thema>XML</thema>
  </buch>
  <buch id="b2" jahr="2022">
    <titel>Daten sauber modellieren</titel>
    <autor>Jonas Weber</autor>
    <umfang>310</umfang>
    <thema>Datenbanken</thema>
  </buch>
  <buch id="b3" jahr="2021">
    <titel>Pfade und Abfragen</titel>
    <autor>Lena Brandt</autor>
    <umfang>180</umfang>
    <thema>XML</thema>
  </buch>
  <buch id="b4" jahr="2023">
    <titel>Python ohne Umwege</titel>
    <autor>Mira Koch</autor>
    <umfang>420</umfang>
    <thema>Programmierung</thema>
  </buch>
</katalog>
Den Katalog haben wir uns ausgedacht, du kannst ihn also frei abwandeln. Das Wurzelelement katalog enthält vier buch-Elemente, jedes mit den Attributen id und jahr. Das Element umfang nennt die Seitenzahl.
XPath-Ausdrücke: Pfade durch den Baum
Ein XPath-Ausdruck beschreibt den Weg zu den Knoten, die du willst. Ein Schrägstrich geht eine Ebene tiefer. Zwei Schrägstriche suchen auf jeder Ebene, eckige Klammern filtern. Alle Beispiele haben wir in BaseX 9.7 mit basex -i katalog.xml "<Ausdruck>" getestet, das Dokument ist dabei der Ausgangspunkt jeder Query:
/katalog/buch/titelliefert alle viertitel-Elemente.//buch[@jahr > 2020]/titel/text()ergibt „Daten sauber modellieren“, „Pfade und Abfragen“ und „Python ohne Umwege“.//buch[thema = "XML"]/autor/string()ergibt zweimal „Lena Brandt“.count(//buch)ergibt 4,sum(//umfang)ergibt 1150.
Das @ steht für Attribute. count() und data() stammen aus der Bibliothek, die sich XPath und XQuery teilen. Jeder Wert hat dort einen bestimmten Typ, etwa xs:integer für ganze Zahlen.
Der FLWOR-Ausdruck Schritt für Schritt
FLWOR wird wie das englische „flower“ ausgesprochen. Die Buchstaben stehen für die Klauseln for, let, where, order by und return. XQuery-Ausdrücke dieser Art sind das Herz des Standards und entsprechen grob einem SELECT … FROM … WHERE in SQL. Im folgenden Beispiel suchst du alle Bücher unter 300 Seiten, sortiert nach Umfang und jeweils als neues Element.
for $b in /katalog/buch
let $s := xs:integer($b/umfang)
where $s < 300
order by $s
return <eintrag umfang="{$s}">{$b/titel/text()}</eintrag>
So arbeitet die Query:
- for bindet die Variable
$bnacheinander an jedes der vier Bücher. - let legt die Seitenzahl als ganze Zahl in der Variable
$sab. Das zählt beim Sortieren: Ohnexs:integersortiert order by den Inhalt als Text, und 1000 landet dann vor 240. - where lässt nur Bücher mit weniger als 300 Seiten durch, hier b1 und b3.
- order by sortiert aufsteigend nach
$s. - return baut für jeden Treffer ein neues Element. In geschweiften Klammern stehen Ausdrücke, deren Inhalt eingesetzt wird.
Ohne order by kommen die Bücher in Dokumentreihenfolge heraus, also so, wie sie in der Datei stehen.
Die Ausgabe:
<eintrag umfang="180">Pfade und Abfragen</eintrag>
<eintrag umfang="240">XML im Alltag</eintrag>
Drei weitere Beispiele zum Nachbauen
Seit Version 3.0 kennt der Standard auch Gruppen. Dieser Ausdruck zählt Bücher je Thema:
for $b in //buch
group by $t := $b/thema
order by $t
return <thema name="{$t}" anzahl="{count($b)}"/>
Heraus kommen Datenbanken 1, Programmierung 1 und XML 2.
HTML entsteht auf demselben Weg. Die folgende Query baut eine Liste, die neuesten Titel zuerst:
<ul>{
  for $b in //buch
  order by $b/@jahr descending
  return <li>{$b/titel/text()} ({data($b/@jahr)})</li>
}</ul>
Oben steht dann <li>Python ohne Umwege (2023)</li>, ganz unten <li>XML im Alltag (2019)</li>. Und distinct-values(//autor) nennt jeden Namen nur einmal, also Lena Brandt, Jonas Weber und Mira Koch.
Stolperfallen am Anfang
Zwei Fehler kosten Einsteiger besonders viel Zeit:
- Namensräume: Trägt das Wurzelelement ein
xmlns="…", findet//buchkeinen einzigen Knoten. Abhilfe schafftdeclare default element namespace "…";am Anfang oder der Platzhalter*:buch. Für Präfixe gibt esdeclare namespace. - **Gleichheitszeichen und
eq:**//thema = "XML"ergibttrue, sobald irgendein Buch passt. Der Vergleicheqerwartet genau einen Wert und meldet bei vier Themen den Fehler XPTY0004.
Wer diese beiden Punkte kennt, versteht auch die meisten Fehlermeldungen. Sie beginnen mit einem Code wie XPST0003 (Syntaxfehler), den du in der Spezifikation nachschlagen kannst. Die gibt es nur auf Englisch. Zu jedem Code steht dort eine kurze Erklärung.
Wo XQuery heute verwendet wird
Die erste Fassung, Version 1.0, wurde 2007 verabschiedet. Laut W3C-Empfehlung XQuery 3.1 gilt die aktuelle Version seit dem 21. März 2017. Sie brachte unter anderem Maps und Arrays, dazu die Unterstützung von JSON.
Typische Einsatzorte:
- BaseX: 2005 an der Universität Konstanz entstanden, in Java geschrieben, Open Source unter BSD-Lizenz. Die Datenbank beherrscht Version 3.1 samt Update-Erweiterung und Volltextsuche und hat eine grafische Oberfläche.
- eXist-db: eine weitere quelloffene XML-Datenbank, mit der sich auch ganze Webanwendungen in XQuery schreiben lassen.
- Microsoft SQL Server: verwendet eine Teilmenge der Sprache für Spalten vom Datentyp
xml. Microsoft dokumentiert sie in einer eigenen Sprachreferenz. - Publishing: Der Open-Access-Verlag eLife stellt auf GitHub Abfrageskripte bereit, mit denen er seinen XML-Artikelbestand in BaseX auswertet und auf Fehler prüft.
- Behördendaten: Viele Verwaltungsstandards tauschen Daten als XML aus, etwa XJustiz im elektronischen Rechtsverkehr. Solche Dateien kannst du mit denselben Pfaden und FLWOR-Ausdrücken durchsuchen.
Lernweg: in vier Etappen zu eigenen Abfragen
Rechne als Richtwert mit etwa vier Wochen bei rund 5 Stunden pro Woche. Für den Anfang reicht BaseX: herunterladen, katalog.xml öffnen und beliebige Ausdrücke im Editor ausführen.
- Woche 1: XML-Aufbau und XPath. Schreib 20 Pfade gegen den Katalog, mit Filtern und Funktionen.
- Woche 2: FLWOR. Nimm eine Klausel nach der anderen dazu und schau, was sich an der Ausgabe ändert.
- Woche 3: eigene Funktionen mit
declare function, globale Variablen mitdeclare variable, dazugroup byund Maps. - Woche 4: ein kleines Projekt, zum Beispiel ein RSS-Feed oder ein XML-Export deiner Notizen, den du als HTML-Seite ausgibst.
Wer noch nie programmiert hat, holt sich vorher die Grundlagen, etwa über unseren Überblick Programmieren lernen. Willst du XML später aus Skripten heraus verarbeiten, ist der Leitfaden Python lernen ein sinnvoller zweiter Schritt.
Bücher zum Weiterlernen
„XQuery“ von Priscilla Walmsley (O’Reilly, 2. Auflage, Dezember 2015, 762 Seiten, Englisch, ISBN 978-1-4919-1510-3): Das Buch deckt den Standard in Version 3.1 vollständig ab und erklärt nebenbei Namensräume und Schemas. Die zweite Auflage hat neue Kapitel zu Funktionen höherer Ordnung, Maps, Arrays und JSON. Der Verlag stuft es als mittel bis fortgeschritten ein. Es taugt als Lehrbuch und als Nachschlagewerk. Die Autorin saß von 1999 bis 2004 in der XML-Schema-Arbeitsgruppe des W3C.
„XML for Data Architects“ von James Bean (Morgan Kaufmann, 2003, Englisch, ISBN 978-1-55860-907-5): Hier geht es um den Entwurf von XML-Strukturen, die sich wiederverwenden und in andere Systeme einbinden lassen. Ein Abfrage-Lehrbuch ist es nicht. Es passt eher zu Leuten, die XML-Formate selbst gestalten. Erschienen ist es vier Jahre vor der ersten offiziellen Sprachversion.
Weitere Buchsteckbriefe findest du im Lernsafari-Bücherregal.
Kurz beantwortet
Ist XQuery so etwas wie SQL für XML? Im Prinzip ja. Beide fragen Daten ab. XQuery-Ausdrücke arbeiten aber auf Bäumen statt Tabellen und formen das Resultat auf Wunsch selbst als XML oder HTML.
Muss ich XPath vorher lernen? Du lernst es nebenbei mit, denn jede Abfrage nutzt XPath-Pfade. Eine Woche XPath vorweg macht FLWOR deutlich leichter.
Mit welcher Software übe ich? BaseX läuft auf allen gängigen Systemen und setzt nur Java voraus. Einlesen kannst du beliebige XML-Dateien. Für einzelne Abfragen ohne Datenbank genügt die Kommandozeile, etwa basex -i katalog.xml "count(//buch)".